La plupart des guides sur la refonte et le référencement tiennent en une consigne : faites un plan de redirection. C’est nécessaire, et très insuffisant. Sur les refontes que nous menons, comme sur celles que nous auditons après coup, les pertes viennent rarement d’une ligne oubliée dans un tableur. Elles viennent de ce que personne n’a rejoué sur le site réel.
Une règle de redirection jamais testée, une adresse captée par une nouvelle règle de réécriture, une préproduction qui fuit dans l’index, un script resté à son ancienne version après une mise à jour, sans la moindre alerte : rien de tout cela ne se lit dans un plan. Tout cela se mesure, avant, pendant et après.
Ce guide suit l’ordre d’un chantier, avec les chiffres relevés sur nos interventions. Le fil conducteur est la refonte du site de Matthieu Tran-Van, menée à l’automne 2026 : 661 adresses publiques, plus de 1 300 redirections héritées, un hébergement mutualisé resté le même. Avant de lire la suite, une question simple : sauriez-vous dire combien d’adresses publiques compte votre site aujourd’hui ?
Pourquoi une refonte fait-elle perdre du référencement ?
Parce qu’elle change ce que Google a appris du site, et que le design n’en fait pas partie. Google connaît des adresses, les contenus qu’elles servent, les liens qui les relient et la façon dont le serveur répond. Une refonte qui garde ces quatre choses peut tout changer à l’écran sans rien perdre ; une refonte qui en casse une seule peut perdre des positions avec une maquette irréprochable.
Les quatre choses que Google connaît de votre site
- Les adresses. Chaque adresse qui change demande une correspondance ancienne vers nouvelle et une redirection permanente, à tenir dans la durée.
- Les contenus. Titre, texte, données structurées : une page réécrite pendant la refonte n’est plus la page que Google avait classée.
- Les liens internes. Menu, pied de page, blocs de contenus liés : une adresse conservée peut perdre tous ses liens sans que rien ne s’affiche en erreur.
- Les réponses du serveur. Codes de statut et temps de réponse règlent le rythme auquel Google explore le site.
Ne pas tout changer le même jour
La documentation de Google sur les déménagements de site le dit sans détour : planifier les changements l’un après l’autre, pas tous en même temps. Or une refonte cumule volontiers une nouvelle charte, un nouveau thème, une nouvelle arborescence et, tant qu’à faire, un nouvel hébergeur. Quand le trafic baisse ensuite, plus personne ne sait quel changement accuser.
Notre règle : tout ce qui peut rester en place reste en place, à commencer par les adresses, et l’hébergement quand il n’est pas en cause. Sur le chantier qui sert de fil à ce guide, la charte, le socle technique et les nouvelles sections ont changé. Aucune adresse existante n’a bougé, et l’hébergeur est resté le même. C’est ce qui permet, plus bas, d’attribuer un gain de temps de réponse au site lui-même et pas à un serveur neuf.
Le calendrier de Google n’est pas celui du chantier
Une refonte se met en ligne en quelques secondes ; Google la digère en semaines. Les ordres de grandeur ci-dessous ont été présentés par Gary Illyes au Search Central Live de Barcelone, début octobre 2026, et rapportés par le compte rendu de l’agence ROAST (source secondaire : Google n’a pas publié les diapositives, et ne précise ni l’échantillon ni ce que « typique » recouvre).
| Ce que Google met à jour | Délai typique | Délai le plus lent |
|---|---|---|
| Découverte d’une nouvelle adresse | environ 20 heures | des semaines, ou jamais |
| Nouveau passage sur une adresse connue | environ 30 jours | des semaines, ou jamais |
| Traitement d’un sitemap | environ 24 heures | jusqu’à 14 jours |
| Changement d’adresse canonique | 1 à 3 semaines | des mois |
| Prise en compte des liens | de quelques minutes à 3 semaines | des mois |
| Migration d’un site | 1 à 3 mois | de 6 mois à plus d’un an |
Deux lignes comptent pour une refonte. Une page connue attend son prochain passage, une trentaine de jours en régime normal : deux semaines après la mise en ligne, Google n’a pas encore relu tout le site. Et une migration se juge sur un à trois mois, pas sur la courbe du lendemain. Nous y revenons au moment du suivi.
Que faut-il inventorier avant de toucher au site ?
Trois choses : les adresses, les redirections, et un état de référence daté dans la Search Console. Sans cet inventaire, « rien n’a changé » reste une impression, et une impression ne se rejoue pas le jour de la mise en ligne.
Toutes les adresses publiques, pas seulement le sitemap
Le sitemap d’une extension SEO liste ce que l’extension veut montrer, pas ce que le site sert. L’inventaire se tire de la base : contenus publiés de tous les types publics, archives, termes de toutes les taxonomies publiques, auteurs ayant publié. Sur notre chantier, il donnait 661 adresses, dont 554 articles et 61 pages, le reste en rubriques, étiquettes et pages d’auteur.
Le même inventaire se tire sur la copie de travail, et les deux listes se comparent ligne à ligne. Chaque ligne présente d’un seul côté est un contenu renommé, dépublié ou supprimé pendant le chantier, à trancher avant la mise en ligne. Ce contrôle ne coûte qu’une commande, et il se relance autant de fois qu’il le faut.
L’historique des redirections, règle par règle
Un site qui a vécu porte un historique de redirections que plus personne n’a relu. Ici : 1 338 règles, dont 611 créées automatiquement par l’extension à chaque changement d’adresse d’un article. Une refonte est le bon moment pour les relire, triées par nombre d’utilisations et date du dernier passage, avec un ordre de décision simple pour chaque source.
- un contenu du site sur le même sujet ;
- à défaut, une page précise d’un autre site, jamais son accueil ;
- à défaut, une réponse 410 (contenu supprimé).
Sur un autre site dont nous avons relu l’historique en septembre 2026, les 142 règles se sont réparties ainsi : 99 vers un contenu du site, 8 vers une page précise d’un site de repli, 11 en 410 et 24 désactivées. Deux pièges reviennent à chaque relecture. Une expression régulière de l’ancien site capte une page créée depuis : une règle sur ^/a-propos(.*)$ qui renvoyait vers l’accueil masquait une nouvelle page « À propos ». Et sous nginx, une ancienne adresse en .php est traitée par le serveur avant WordPress : la règle posée dans l’extension ne s’exécute jamais, alors que son compteur, hérité de l’hébergement précédent, semble prouver le contraire.
Un état de référence daté
Après la mise en ligne, il n’y a plus d’avant. Nous relevons donc, avant de commencer : le temps de réponse moyen par type de fichier dans les statistiques d’exploration, le nombre de pages indexées et les motifs d’exclusion, et pour les pages qui portent le chiffre d’affaires, leurs requêtes et leur position sur trois et seize mois. Les titres et les descriptions se sauvegardent à part : sur un site où les révisions sont désactivées, seule une sauvegarde garde le titre d’avant.
Faut-il garder les mêmes adresses lors d’une refonte ?
Oui, chaque fois que c’est possible. Une adresse conservée garde ses liens entrants et son historique sans dépendre de rien. Une adresse redirigée dépend d’une règle que Google demande de garder « aussi longtemps que possible, en général au moins un an », et que le prochain prestataire supprimera peut-être sans savoir pourquoi elle était là.
Ce que coûte une redirection
Une redirection est un aller-retour complet avant le premier octet utile. Nous l’avons mesuré en septembre 2026 sur la redirection du domaine nu vers le www d’un site : laissée à WordPress, elle n’était jamais mise en cache et coûtait 430 ms depuis Paris, près d’une seconde depuis les Antilles. Portée par une règle au niveau du CDN, la même redirection répondait en 36 à 60 ms. Une redirection produite par une extension fait démarrer tout le CMS pour renvoyer quelques dizaines d’octets.
Google suit jusqu’à dix sauts, ce qui ne veut pas dire qu’il faut lui en donner. Chaque saut compte comme une requête d’exploration à part entière, et les liens internes ne devraient jamais transiter par une redirection. Notre guide sur les codes de statut HTTP détaille le coût de chacun selon l’endroit où il est produit.
Quand l’adresse doit changer : une table, pas un motif
Changer de CMS impose parfois de changer d’adresses, et la tentation est de tout régler par une règle générique. Lors de l’audit d’un site communautaire migré depuis un forum phpBB, les anciennes adresses de sujets répondaient toutes 404. Nous en avons testé 142 : 135 sujets existaient toujours sur le nouveau site, mais sous un autre numéro. Aucun motif ne pouvait les relier. Il fallait une table de correspondance, adresse par adresse, construite pendant la migration, quand l’ancien et le nouveau numéro étaient encore côte à côte dans la même base.
Quand le contenu disparaît : 410, pas l’accueil
Rediriger en masse vers l’accueil est la fausse bonne idée la plus répandue. Google recommande de ne pas rediriger de nombreuses anciennes adresses vers une destination sans rapport, qu’il peut traiter en « soft 404 », et précise dans son guide du budget d’exploration que ces pages continuent d’être explorées en pure perte.
Sur un de nos sites éditoriaux, recentré sur des guides pratiques, 367 actualités périmées ont été supprimées. Elles répondent 410. Vingt-cinq anciennes adresses avaient un vrai successeur : elles ont reçu leur redirection le jour où le guide correspondant a été publié, pas avant. Et l’extension qui redirigeait toute adresse introuvable vers l’accueil a été coupée. Google traite 404 et 410 de la même façon ; le 410 dit seulement plus nettement que la suppression est voulue.
Les collisions que personne ne cherche
Une adresse peut rester en place et servir autre chose. Cas vu le 16 novembre 2026 sur une préproduction : une nouvelle page créée à la même adresse qu’une rubrique existante. Avec la base de catégorie retirée par l’extension SEO, la règle de la rubrique passe avant celle des pages : l’adresse répond 200, sans erreur, et sert l’archive de la rubrique. La page est inatteignable alors que l’éditeur la montre. D’où une règle de contrôle : un code 200 ne prouve pas que c’est la bonne page. Sur un échantillon par type de contenu, nous comparons aussi le titre et l’adresse canonique.
Comment vérifier un plan de redirection ?
En le rejouant sur le serveur, adresse par adresse, et en comparant le code de réponse et la destination à ceux d’avant. Relire le tableur ne prouve rien : ce sont les réponses du serveur que Google lira, pas le plan.
Rejouer chaque adresse, en série
Le script tient en quelques lignes : il demande chaque adresse de l’inventaire à la cible et n’imprime que ce qui n’est pas un 200, avec la destination des redirections.
#!/bin/bash
# Usage : controle-adresses.sh inventaire.tsv https://cible.example
# inventaire.tsv : une adresse relative par ligne, en cinquième colonne.
REF=$1; CIBLE=$2
cut -f5 "$REF" | sort -u | while read -r u; do
  curl -s -o /dev/null --max-time 40 -A "Mozilla/5.0 controle-adresses" \
       -w "%{http_code} %{redirect_url} $u\n" "$CIBLE$u"
  sleep 0.4                      # une requête à la fois : voir plus bas
done | awk '{ n[$1]++; if ($1 != "200") print }
            END { for (c in n) print "TOTAL " c " : " n[c] > "/dev/stderr" }'
Le sleep n’est pas une politesse. Sur l’hébergement mutualisé du chantier, 661 adresses demandées par six requêtes parallèles ont laissé 375 réponses vides ; à deux requêtes parallèles, encore 296. En série, avec 0,4 s de pause, toutes les adresses ont répondu. Une réponse vide n’est pas un écart, c’est l’hébergeur qui coupe la rafale, et un contrôle qui n’en tient pas compte fabrique de fausses alertes.
L’inverse est vrai aussi : un passage sans aucun écart ne prouve rien s’il n’a pas de témoin. Nous glissons dans l’inventaire une adresse dont l’écart est connu, que le script doit signaler. Sans elle, « zéro écart » peut simplement vouloir dire que le script a interrogé deux fois le même site.
Résultat sur le chantier, avant la mise en ligne puis juste après : 640 pages servies et 21 redirections, identiques des deux côtés. Le seul écart était voulu : une redirection en deux sauts ramenée à un seul.
Un seul gestionnaire de redirections
Le site portait deux outils capables de rediriger : une extension dédiée, et le module de l’extension SEO. Le second ne contenait qu’une seule règle, ce qui ne l’empêchait pas de travailler : il journalisait chaque adresse introuvable avec l’adresse IP complète du visiteur, soit 4 745 lignes en une semaine, en double du journal de la première. Une adresse IP complète est une donnée personnelle ; ce journal n’avait aucune raison d’exister.
Les 1 338 règles ont été reprises dans un seul outil, puis chaque règle active a été rejouée et comparée à l’ancienne : même code, même destination, à trois exceptions près, toutes expliquées. L’import a aussi révélé 33 adresses sources présentes deux fois. Et un dernier détail, que seul un contrôle le lendemain pouvait montrer : journal coupé, l’extension avait encore écrit 2 862 lignes le lendemain matin. Elle journalisait ses propres redirections sans consulter son réglage. Un réglage décoché n’est pas un comportement vérifié.
Les redirections que WordPress ne fait pas pour vous
WordPress redirige de lui-même l’ancienne adresse d’un article renommé. Il ne le fait pas pour une page. Toute page renommée pendant une refonte demande donc une règle explicite, ou une extension qui surveille les changements d’adresse, option désactivée par défaut sur une installation neuve. C’est exactement le genre de filet qui disparaît sans bruit quand on remplace un outil par un autre : sur ce chantier, la surveillance a été réactivée dans le nouvel outil, puis testée par un vrai changement d’adresse, aussitôt annulé.
Comment travailler sur une copie sans la montrer à Google ?
En l’isolant au niveau du serveur, pas seulement de WordPress, et en vérifiant que le cache ne contourne pas l’isolement. Une préproduction alimentée par une copie de la production contient tout ce que le site a de vrai : contenus, comptes, tâches planifiées. Indexée, elle devient le doublon exact du site qu’elle prépare.
Le cache passe avant le contrôle d’accès
Le 7 octobre 2026, notre préproduction était fermée par un contrôle d’accès écrit en PHP, testé cache vide : tout visiteur sans autorisation recevait un refus. Sauf que le cache de pages d’une extension est servi avant que WordPress ne démarre, donc avant ce contrôle. Après une première visite autorisée, la page mise en cache a été servie en 200 à tout le monde, cinq robots compris le jour même.
La parade tient en une ligne de configuration : rendre le cookie d’accès obligatoire pour recevoir le cache. Une authentification HTTP posée par le serveur web n’a pas ce défaut, puisqu’elle passe avant PHP. Dans les deux cas, un en-tête X-Robots-Tag: noindex envoyé par le serveur ferme la porte aux moteurs, et c’est aussi le premier réglage à retirer le jour de la mise en ligne.
Une copie n’est jamais identique à l’original
Un exemple du même chantier : la copie contenait 18 421 images WebP dérivées, 245 Mo que rien ne semblait utiliser. Sur la préproduction, servie par nginx, aucune page ne les demandait. Sur la production, servie par Apache, une règle du fichier .htaccess les envoyait à tout navigateur compatible, à la place des JPEG. Les supprimer aurait alourdi chaque image du site. La preuve qu’un fichier ne sert pas se cherche sur le serveur qui le servira.
La même prudence vaut pour les extensions. Sur une copie isolée, celles que l’on a neutralisées pour l’isolement (envoi de courriels, optimisation d’images, mesure d’audience) apparaissent inactives alors qu’elles tournent en production. L’état d’une extension se lit sur le site réel, jamais sur sa copie.
Le site vit pendant les travaux
Entre la copie et la mise en ligne, la production continue de bouger. Le 26 octobre, nous avions contrôlé qu’aucun contenu n’avait changé depuis la copie. Le jour même, après notre passage, le client publiait une offre à durée limitée sur une page de vente. Dans le même intervalle, une mise à jour automatique avait fait passer la production devant la préproduction d’une version mineure de WordPress.
Ce delta se mesure donc deux fois : à chaque point d’étape, et une dernière fois juste avant de basculer, avec un gel des publications le jour même. Contenus créés ou modifiés, commentaires, comptes, fichiers ajoutés, versions. Tout ce qui est écrit en production après la copie disparaît à la mise en ligne si personne ne l’a reporté.
Remplacer les adresses de la copie, partout
Passer de l’adresse de travail à l’adresse publique a demandé 41 086 remplacements dans la base. Le contrôle ne porte pas sur ce nombre, mais sur ce qui reste : zéro occurrence de l’adresse de travail, y compris sous sa forme échappée (https:\/\/), celle qu’un remplacement de l’adresse complète ne trouve pas dans les données JSON. Et certaines données dérivent de l’adresse sans la contenir : 263 empreintes de redirection, calculées à partir d’adresses que le remplacement venait de modifier, ont dû être recalculées.
Votre site est-il aussi rapide que vos visiteurs l’espèrent ?
Que nettoyer pendant une refonte, et que laisser en place ?
Tout ce qui pèse sur le temps de réponse et sur la maintenance, à condition d’avancer par lots contrôlés. Une refonte est le seul moment où tout est déjà ouvert sur l’établi. C’est aussi celui où il est le plus tentant de tout changer à la fois : un lot, un contrôle, puis le suivant.
Les extensions et les blocs hérités
Le nettoyage a ramené 27 extensions actives à 13. Parmi les extensions retirées, trois bibliothèques de blocs installées au fil des années. La plus utilisée était présente dans 361 contenus : 1 427 questions en accordéon, 7 377 éléments de liste, 1 029 boutons. Retirer l’extension sans convertir ces blocs aurait laissé des pages cassées dans l’éditeur, et des contenus privés de leur mise en forme.
La conversion s’est faite par script, avec trois garde-fous. Le convertisseur ne touche que les blocs de l’extension à retirer, et le reste de chaque contenu doit ressortir identique à l’octet près. Chaque contenu converti est ensuite relu par l’éditeur de blocs : cinq étaient en écart au premier passage, aucun au second. Enfin, les données structurées survivent : un accordéon de questions qui produisait un balisage FAQ doit toujours le produire, une seule fois par page. C’est le genre de détail qu’une conversion visuellement parfaite fait disparaître.
La base de données
- Encodage. 25 tables héritées en latin1 ont été converties en utf8mb4. Le symptôme était discret : des flèches saisies dans un tableau s’enregistraient en points d’interrogation.
- Résidus. 429 réglages et 41 864 métadonnées appartenaient à une cinquantaine d’extensions disparues depuis longtemps.
- Révisions. Elles occupaient 522 Mo d’une base de 894 Mo.
- Requêtes. Sur les 257 requêtes SQL d’un article, 107 lisaient chacune un réglage absent de la base. Une lecture groupée a ramené le total à 172.
Ce dernier point illustre ce qu’une refonte ajoute sans le dire : une extension fraîchement installée dont les réglages n’ont jamais été enregistrés interroge la base à chaque page pour chaque réglage manquant. Un site neuf peut ainsi faire plus de requêtes que l’ancien, tout en ayant moins d’extensions.
Comment basculer sans risque ?
En changeant un pointeur plutôt qu’en écrasant le site. Le nouveau site est déposé dans un dossier et une base à part, puis le domaine est pointé vers ce dossier. L’ancien site reste intact à côté, et le retour arrière tient en une action, sans page de maintenance.
Un nouveau dossier, une nouvelle base, l’ancien site intact
Sous cPanel, le pointeur est la racine du domaine. Le principe vaut partout : sur un média à fort trafic dont nous avons remplacé le thème, la bascule a pris 1,4 s, avec un retour arrière testé en 3 s et jamais utilisé. Ce qui rend la méthode sûre n’est pas sa vitesse, c’est que le retour arrière a été joué avant le jour J.
Elle a ses pièges, tous rencontrés :
- un fichier de configuration recopié de l’ancien site peut porter des chemins absolus, et le nouveau site chargerait alors les extensions de l’ancien ;
- les fichiers écrits hors du dossier des contenus ne suivent pas une copie de ce dossier : un fichier
llms.txtécrit par l’extension SEO à côté de ce dossier a dû être régénéré ; - sur un mutualisé, la version de PHP vaut pour tout le compte : en cas de retour arrière, l’ancien site revient sous la version du nouveau, qu’il faut donc avoir testée.
Voir le nouveau site avant qu’il ait une adresse
Un site déposé dans un dossier que rien ne sert encore ne peut pas être visité. Il peut être exécuté : nous avons rendu 22 adresses types par le nouveau site, en ligne de commande, avec une requête simulée, avant de changer le pointeur. Aucune erreur PHP, aucune balise noindex, aucune trace de l’adresse de travail. Sur le média cité plus haut, une recette du même ordre, menée sur le vrai site par une adresse réservée, avait révélé un lecteur vidéo qui se plaçait grâce à un repère de l’ancien thème, défini dans la configuration de la régie et nulle part dans le code du site.
Les erreurs passagères du premier passage
Au premier passage du contrôle d’adresses après la bascule, 20 adresses sur 661 ont répondu 503 ; au second, toutes répondaient 200. Cache vide, hébergement mutualisé, six cents pages demandées d’affilée : le serveur a protégé ses voisins. Ce n’est pas grave pour Google, qui ralentit temporairement son exploration devant des erreurs serveur et recommande de ne pas en renvoyer plus de deux ou trois jours. Quelques minutes ne coûtent rien.
Cela dit dans quel ordre agir : le préchargement du cache de pages se lance juste après le changement de pointeur, jamais avant. Un service de préchargement va chercher les pages à leur adresse publique : activé trop tôt, il précharge l’ancien site, et calcule son CSS sur l’ancien thème.
Rouvrir à l’indexation, vraiment
Décocher la case « demander aux moteurs de ne pas indexer ce site » ne suffit pas. Trois verrous se superposent : le réglage de WordPress, qui produit une balise ; l’en-tête X-Robots-Tag, posé par le serveur ou le CDN pour la préproduction, qui se retire dans leur configuration ; et les noindex page par page, hérités de modèles importés (mentions légales, contact). Nous contrôlons la balise et l’en-tête de chaque gabarit, le sitemap et le fichier robots.txt avant de déclarer le site ouvert.
Que contrôler juste après la mise en ligne ?
Les adresses, puis les fonctions, puis ce que lisent les robots. Les trois, parce qu’un contrôle d’adresses ne voit pas un composant cassé.
Les adresses, une seconde fois
Le script d’avant la bascule se rejoue tel quel, avec la production pour cible et l’inventaire d’avant pour référence. C’est le contrôle le moins coûteux de tout le chantier, et celui qui permet d’écrire, chiffres à l’appui, qu’aucune adresse n’a été perdue.
Les fonctions, pas seulement les codes de réponse
Une page peut répondre 200, porter le bon lien, n’afficher aucune erreur dans la console, et ne plus fonctionner. Le cas le plus sournois tient aux scripts minifiés par une extension de cache. Celle-ci fabrique une copie allégée de chaque script et la nomme d’après le fichier source, pas d’après son contenu : quand une extension est mise à jour, l’ancienne copie continue d’être servie, à côté de la nouvelle feuille de style.
Relevé sur un site où une extension avait été mise à jour quatre minutes après la fabrication des copies, le jour d’une bascule : 24 copies sur 47 étaient plus anciennes que leur source, dont le script d’un lecteur vidéo et ceux du formulaire de contact. Le lecteur s’ouvrait au clic et restait invisible, masqué par une feuille de style qui ne connaissait plus son ancien format.
Le contrôle tient en une boucle, à lancer après toute mise à jour sur un site dont les scripts sont minifiés :
# Copies minifiées plus anciennes que leur source (ici WP Rocket, WordPress dans ./wordpress).
# Liste dans un fichier : certains mutualisés n'ont pas /dev/fd, et une boucle "< <(find …)" y lit zéro ligne.
L=$(mktemp)
find wordpress/wp-content/cache/min/1 -type f \( -name '*.js' -o -name '*.css' \) > "$L"
total=$(wc -l < "$L"); vues=0; perimees=0
while IFS= read -r copie; do
  vues=$((vues+1)); source=${copie#wordpress/wp-content/cache/min/1/}
  [ -f "$source" ] && [ "$source" -nt "$copie" ] && { perimees=$((perimees+1)); echo "PÉRIMÉE $source"; }
done < "$L"; rm -f "$L"
echo "copies : $total, examinées : $vues, périmées : $perimees"   # examinées doit égaler copies
Notre recette d’après bascule comprend aussi un clic réel sur chaque composant dont vit le site : lecteur vidéo, formulaire, recherche, prise de rendez-vous, paiement. Aucun de ces composants n’apparaît dans un relevé de codes de réponse, ni dans un score Lighthouse.
Ce que lisent les robots
- Les données structurées : elles ne balisent que ce qui est affiché. Un fil d’Ariane déclaré dans le balisage alors qu’il n’apparaît plus dans la nouvelle charte est une erreur que la refonte vient de créer.
- Le menu et le pied de page : pendant ce chantier, deux entrées du nouveau menu ont pointé un temps vers des pages qui n’existaient pas, et 29 pages publiées masquaient l’en-tête et le menu, héritage d’anciennes pages de vente. Elles étaient en ligne, et hors du maillage.
- Le sitemap : il doit lister les nouvelles sections, et aucune taxonomie technique créée par le constructeur de pages.
Les fichiers perdus
Une image oubliée dans la copie ne coûte pas qu’un pictogramme cassé. Sur un CMS, une adresse introuvable échappe au cache, démarre l’application et rend la page d’erreur complète. Nous avons vu un site où une image supprimée, mais toujours appelée par la feuille de style de 32 fiches, faisait télécharger à chaque affichage une page 404 de 49 Ko. Après toute migration, croiser un crawl avec les journaux du serveur retrouve ces fichiers en quelques minutes.
Une refonte peut-elle accélérer l’exploration par Google ?
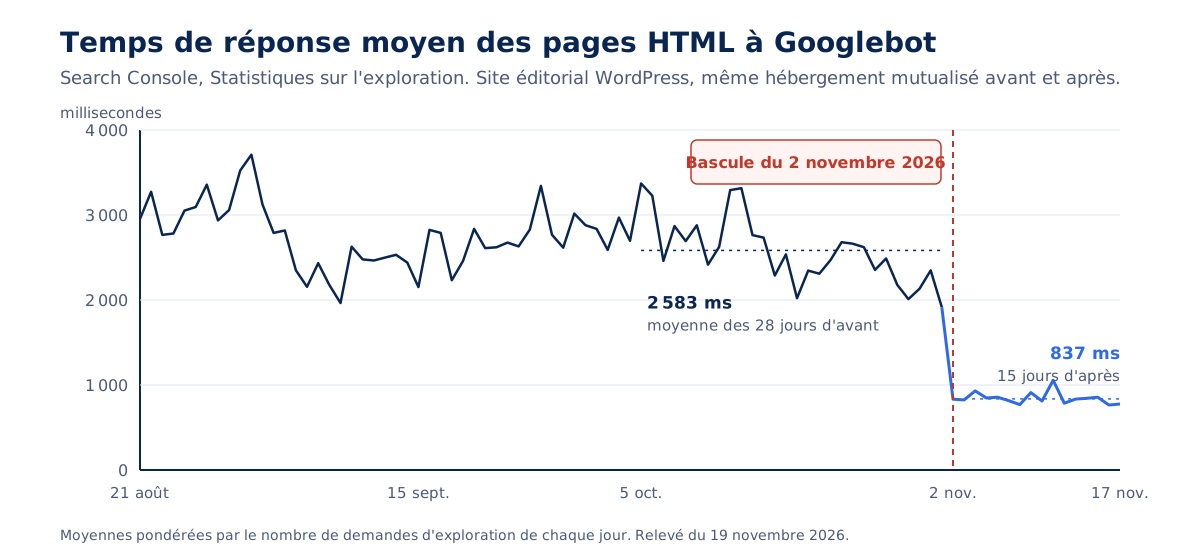
Elle peut diviser par trois le temps que Google passe à obtenir chaque page, sans changer d’hébergement. Sur notre chantier, le temps de réponse moyen des pages HTML à Googlebot est passé de 2 583 ms sur les 28 jours d’avant à 837 ms sur les 15 jours d’après, soit 68 % de moins. La baisse s’est faite d’un jour sur l’autre : 1 915 ms la veille de la bascule, 833 ms le jour même.
Ce que mesure ce chiffre
Les statistiques sur l’exploration de la Search Console donnent le temps moyen de récupération de chaque ressource, sans le rendu. La moyenne générale mêle pages, images et scripts : il faut ouvrir la ventilation par type de fichier et lire la ligne HTML avant de conclure quoi que ce soit sur le serveur. Nous pondérons ensuite chaque jour par son nombre de demandes, pour qu’un jour à 46 demandes ne pèse pas autant qu’un jour à 300.
Un détail rend le résultat plus net : les pages ont grossi. Leur poids moyen téléchargé par Googlebot est passé d’une soixantaine de kilooctets à près de cent, parce que la nouvelle version embarque dans chaque page le CSS dont elle a besoin au lieu de l’appeler dans des feuilles externes. Des pages plus lourdes, servies trois fois plus vite : le gain vient du temps de fabrication, pas du transfert.
D’où vient le gain
Trois changements sont arrivés le même jour : un socle allégé (deux fois moins d’extensions, une base nettoyée), une version de PHP plus récente, et un cache de pages préchargé sur tout le site. Nous n’avons pas isolé la part de chacun, et nous ne prétendrons pas le contraire. Notre expérience désigne le troisième. Sur un site éditorial, les pages fabriquées à la demande sont dix à cinquante fois plus lentes que les pages servies depuis le cache, et un robot demande précisément celles que les visiteurs ne demandent pas : les 500 articles anciens, pas les dix du moment.
C’est le mécanisme que nous décrivons dans notre guide sur ce que les robots coûtent au serveur : la longue traîne froide. Un cache qui ne couvre que les pages populaires laisse aux robots tout le reste, au prix fort. Le temps de réponse du serveur que mesurent vos visiteurs et celui que subit Googlebot sont deux chiffres différents.
Ce que ce chiffre ne prouve pas
Google n’explore pas davantage le site pour autant. Les demandes de pages HTML sont passées de 168 à 99 par jour sur les mêmes périodes, et ce n’est pas une mauvaise nouvelle : un site de 661 adresses n’a pas de problème de budget d’exploration. Google réserve explicitement ce sujet aux sites de plus d’un million de pages, ou de plus de dix mille quand leur contenu change chaque jour, et juge son rapport d’exploration inutile sous un millier de pages.
Ce que la vitesse de réponse achète ici est ailleurs. Google écrit que la vitesse à laquelle il découvre et traite les adresses d’un site déplacé dépend de leur nombre et de la vitesse du serveur : un serveur qui répond en moins d’une seconde fait digérer la refonte plus vite. Il garde aussi de la marge le jour où un robot insiste, là où un serveur à 2,6 s par page est déjà à la limite. Et il sert plus vite les visiteurs qui tombent sur une page hors cache, ce qui rejoint le lien entre performance et référencement.
Que surveiller dans la Search Console, et pendant combien de temps ?
Un mois avant de conclure, trois pour un bilan, et toujours page par page. Le total du site est le dernier endroit où une perte se voit : une moyenne stable peut cacher six pages qui reculent.
Deux semaines : assez pour une alerte, pas pour un bilan
Voici ce que nous savions quatorze jours après la bascule, comparés aux quatorze jours d’avant : une position moyenne inchangée (36,4 puis 36,3), des impressions passées de 95 600 à 121 000, des clics stables à un niveau trop faible pour être interprété (161 puis 153). Et 51 pages des nouvelles sections déjà affichées dans les résultats, cohérent avec une découverte en une vingtaine d’heures.
Cela autorise à écrire « aucune perte visible », pas « progression ». Une partie des pages n’a pas encore été relue par Google, et une hausse d’impressions sur deux semaines peut tenir à la saison autant qu’au site. Le premier bilan honnête se fait sur 28 jours contre 28 jours, le second à trois mois, en haut de la fourchette typique d’une migration.
La moyenne cache les pages qui reculent
Sur une refonte récente, la position moyenne du site était stable et plusieurs pages d’offres progressaient. En ouvrant le détail par page, six pages locales, toutes du même gabarit, avaient toutes reculé : de la position 22,5 à 30,2 en moyenne, l’une d’elles de 17,7 à 31,5. Leurs adresses n’avaient pas changé. Mais la nouvelle charte ne les liait plus depuis le pied de page.
Nous n’avons pas la preuve que ce soit la cause, et deux semaines sont courtes pour l’affirmer. C’est le premier suspect, et le premier correctif à tester. La leçon vaut indépendamment du verdict : l’inventaire d’avant refonte doit aussi lister les liens présents sur toutes les pages, menu et pied de page, parce qu’une adresse conservée peut perdre ses liens internes sans produire la moindre erreur.
Lire une position moyenne
La position moyenne de la Search Console est une moyenne pondérée par les impressions. Une page qui commence à s’afficher sur de nouvelles requêtes lointaines voit sa position moyenne chuter sans avoir perdu un seul rang sur ses requêtes d’origine. Avant de conclure à une baisse, nous traçons la courbe de la page seule sur seize mois, mois par mois, avec la date de chaque modification à côté. Comparer deux périodes dit combien une page a perdu ; seule la courbe dit quand, et donc pourquoi.
Les rapports à ouvrir chaque semaine
- Indexation des pages : le nombre de pages indexées (ici 577 avant, 562 deux semaines après), et surtout les motifs. Les adresses introuvables connues de Google sont passées de 80 à 67 ; une ligne « Page avec redirection » ou « Détectée, actuellement non indexée » qui enfle demande une explication.
- Statistiques sur l’exploration : la répartition des réponses par code, où une hausse des erreurs serveur ou des refus se voit avant toute baisse de trafic.
- Performances, par page : les pages qui portent le chiffre d’affaires, une par une, contre leur état de référence.
Qui fait quoi entre l’équipe technique et le consultant SEO ?
Le consultant SEO décide de ce que le site doit dire et à qui ; l’équipe technique garantit que rien ne se perd en route, et le prouve. Les deux métiers se recouvrent juste assez pour que chacun croie que l’autre a vérifié.
Sur le chantier de ce guide, le partage était écrit dès le départ. Au consultant : l’arborescence des nouvelles sections, les contenus, les priorités. À nous : les types de contenus et leurs adresses, les gabarits, les données structurées, les redirections, les temps de réponse, et les contrôles chiffrés décrits ici. Deux règles ont évité l’essentiel des frictions. Une seule source fait foi pour les contenus, le document du consultant, dont les fiches ont été générées sans ressaisie. Et comme plusieurs personnes retouchent le site pendant le chantier, toute modification repart de la version en ligne, jamais d’une copie de travail vieille de trois jours.
Par où commencer ?
Par compter. Combien d’adresses publiques, combien de redirections, quel temps de réponse pour Googlebot, quelles pages portent le trafic. Puis décider ce qui ne bougera pas, et l’écrire. Puis seulement ouvrir la maquette.
Cet ordre évite les deux erreurs les plus fréquentes : traiter le référencement comme une étape de fin de projet, avec un plan de redirection rédigé la veille de la mise en ligne ; ou le traiter comme un sujet de contenu seulement, en oubliant que Google lit d’abord des adresses, des codes de réponse et des temps de réponse. Entre les deux, une méthode tient en trois gestes : inventorier, rejouer, mesurer, avant, le jour même, et pendant les trois mois qui suivent.
C’est la méthode que nous appliquons dans nos prestations de refonte de site internet. Si votre refonte est déjà en ligne et que les courbes vous inquiètent, un audit de performance retrouve ce qui a changé côté serveur, et un monitoring le signale avant la Search Console. Et si vous ne deviez retenir qu’une question avant de signer une maquette : qui, dans votre projet, est chargé de prouver que rien n’a été perdu ?