Le débat sur les robots d’intelligence artificielle se joue en public sur le terrain du droit d’auteur : qui a le droit de lire vos pages pour entraîner un modèle, et contre quelle compensation. Pendant ce temps, une autre question reste sans réponse dans la plupart des équipes : qui, chaque nuit, recalcule vos pages les moins visitées, et ce que ce travail coûte à vos visiteurs humains.
Un robot ne se comporte pas comme un visiteur. Il demande précisément les pages que votre cache ne contient pas, suit des liens qu’aucun humain ne suivrait, et parfois exécute le JavaScript de vos pages jusqu’à remplir et vider un panier. Son coût atterrit sur le serveur d’origine, dans le temps de réponse (le TTFB) de tout le monde, alors que le laboratoire continue d’afficher un site rapide.
Ce guide prend les robots d’IA sous l’angle de la charge : mesurer leur part, comprendre pourquoi une requête de robot coûte plus qu’une requête humaine, et maîtriser cette charge sans fermer la porte à ce qui vous apporte des lecteurs. Avant de lire la suite, une question simple : quelle part des requêtes qui atteignent votre serveur vient d’un humain ?
Quelle part du trafic web vient aujourd’hui des robots ?
Environ deux requêtes de pages HTML sur trois. Sur le réseau de Cloudflare, du 8 au 15 octobre 2026, les robots représentaient 39,5 % de l’ensemble des requêtes HTTP et 65,1 % des requêtes de pages HTML, celles qui mobilisent PHP. Les robots d’IA en forment une part minoritaire, celle qui croît le plus vite.
Ce que mesure Cloudflare Radar, et ce qu’il ne mesure pas
Les chiffres de cette section sont relevés le 15 octobre 2026 sur l’API de Cloudflare Radar, pour la fenêtre du 8 au 15 octobre 2026. Radar classe une requête comme automatisée quand son score de robot est inférieur à 30 sur 99 : c’est une classification probabiliste, et elle porte sur le trafic qui traverse le réseau de Cloudflare, soit une part importante du web mais pas le web entier.
Les pourcentages varient selon la fenêtre choisie, et les billets qui reprennent « un chiffre de Cloudflare » mélangent souvent des périodes et des périmètres différents, d’où des écarts d’un facteur dix entre deux articles. Chaque chiffre repris ici porte donc sa fenêtre : un chiffre sans fenêtre datée ne vaut rien dans ce domaine.
Les robots d’IA parmi les robots
Sur les requêtes de pages HTML de la même semaine, Radar ventile ainsi les clients : 55,4 % de robots sans lien avec l’IA (moteurs de recherche, outils SEO, prévisualisations de liens), 34,8 % d’humains, 6,0 % de robots d’IA déclarés et 3,9 % de robots à usage mixte, Googlebot en tête, dont l’index sert aussi bien la recherche classique que les réponses générées. Autrement dit, un dixième des pages HTML servies le sont à un robot d’IA, déclaré ou mixte.
Parmi les requêtes des robots d’IA, Radar distingue la finalité déclarée par l’opérateur : 43,7 % pour l’entraînement de modèles, 39,5 % à usage mixte, 11,6 % pour la recherche et 3,8 % pour une action demandée par un utilisateur. Sur un an, la part de l’entraînement est passée d’environ 35 % en octobre 2025 à un pic de 54 % en juin 2026, avant de redescendre vers 42 % à la mi-octobre ; la recherche, elle, a été multipliée par sept, de 1,7 % à 12,2 % des requêtes.
Les agents les plus actifs de la semaine, en part des requêtes de robots d’IA : Googlebot (23,9 %), ClaudeBot (13,0 %), Meta-ExternalAgent (9,4 %), Bingbot (7,9 %), Applebot (7,8 %), GPTBot (5,9 %), ShapBot (5,3 %, robot de recherche de Parallel, qui indexe le web pour des API d’agents), Amazonbot (4,7 %) et OAI-SearchBot (4,6 %).
Ces robots demandent surtout des pages : 74,3 % de leurs requêtes portent sur du HTML, et 28,9 % reçoivent une réponse en erreur client (4xx), signe d’un volume important de blocages et de pages introuvables.
Pages explorées contre visites renvoyées
Depuis le 1er juillet 2025, Radar publie un ratio entre les pages qu’un opérateur explore et les visites qu’il renvoie vers les sites. Pour la semaine du 8 au 15 octobre 2026 : Perplexity explore 3 419 pages par visite renvoyée, OpenAI 2 084, Anthropic 469, Microsoft 40 et Google 4,8. Ce ratio se lit avec sa limite : un robot d’entraînement n’a aucun mécanisme de renvoi de trafic, son ratio est infini par construction. Sa charge ne sera jamais compensée par des visites, et c’est la raison pour laquelle les deux familles se règlent séparément.
Pourquoi un robot coûte-t-il plus cher qu’un visiteur ?
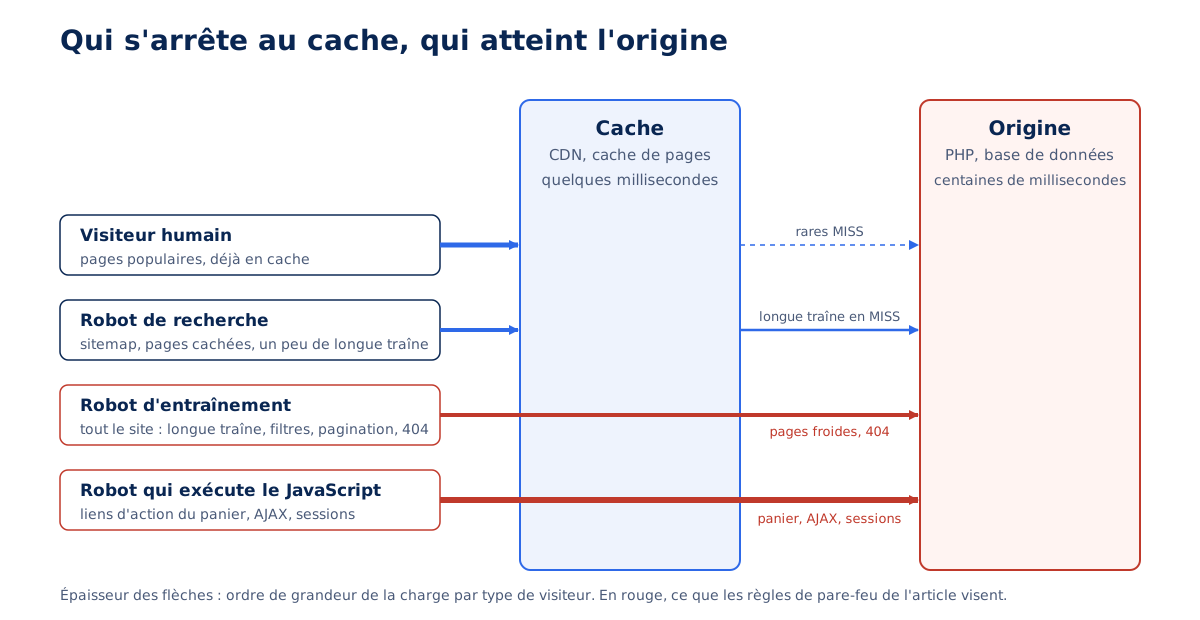
Parce qu’il visite précisément les pages que le cache ne contient pas. Un humain lit les pages populaires, déjà en cache au CDN ou sur le serveur ; un robot parcourt l’intégralité du site, longue traîne, filtres et paginations comprises. Sur une boutique WooCommerce auditée en septembre 2026, un seul robot représentait la moitié des requêtes qui atteignaient l’origine.
La longue traîne froide
Un cache de pages, au CDN comme sur le serveur, ne contient que ce qui a été demandé récemment. Les pages rarement vues (vieux articles, fiches en fin de catalogue, pages de tags) en sortent dès que leur durée de vie expire, et chaque passage de robot les recalcule en PHP avec leurs requêtes SQL. Le robot ne lit donc presque que des MISS, et son coût unitaire est celui d’une page entière recalculée, là où le visiteur moyen coûte une lecture mémoire. Les couches de cache et leur durée de vie sont détaillées dans notre guide du cache web.
Les espaces d’URL infinis
Un site dynamique génère plus d’URL qu’il n’a de contenus : filtres à facettes combinables, tri, pagination profonde, recherche interne, calendriers, paramètres de suivi. Chaque combinaison est une URL distincte pour le robot, donc une page recalculée pour le serveur, et presque jamais une page utile. Les paramètres de campagne jouent le même rôle sur les pages populaires, en fabriquant des variantes que le cache ne reconnaît pas, comme l’explique notre article sur les paramètres de tracking qui détruisent le cache. Un robot qui découvre ces URL explore un espace sans fin aux frais de l’origine.
Les robots qui exécutent le JavaScript
Certains robots rendent les pages dans un navigateur sans écran, comme Googlebot depuis des années. Un robot qui exécute le JavaScript suit aussi les liens que le JavaScript construit, et déclenche les appels réseau de la page. Sur une boutique, cela inclut les liens d’action du panier : ?add-to-cart=, remove_item=, les appels ?wc-ajax= et admin-ajax.php. Chacun crée une session, contourne le cache de pages par construction et rend un panier en PHP. C’est le scénario le plus coûteux qu’un robot puisse déclencher, et le cas détaillé plus loin.
Les erreurs servies sans cache
Sur un CMS, une URL introuvable est souvent la requête la plus chère du site : elle échappe au cache, démarre l’application, exécute la requête principale, constate l’échec puis rend le gabarit d’erreur, tout cela pour ne rien servir. Un robot qui suit de vieux liens ou teste des chemins absents de votre pile (/wp-login.php sur un site Drupal, /.env) produit des 404 applicatives en série. Notre guide des codes de statut HTTP détaille pourquoi une 404 rendue par le CMS coûte des centaines de millisecondes, contre des dixièmes quand le serveur web la sert lui-même.
Ce que les humains encaissent
Les processus PHP sont en nombre fini. Quand des robots en occupent la moitié à recalculer des pages froides, les requêtes humaines attendent leur tour, et le temps de réponse de l’origine monte pour tout le monde. L’effet se lit dans le TTFB mesuré sur le terrain par le Chrome User Experience Report, surtout sur mobile, alors que les tests de laboratoire, lancés à un moment calme sur une page populaire déjà en cache, restent bons.
Notre article sur le TTFB et son optimisation explique cet écart entre terrain et laboratoire. Dans le cas WooCommerce cité plus haut, la dégradation du TTFB terrain mobile était le premier symptôme, avant toute lecture des journaux.
Comment mesurer la charge des robots sur votre site ?
En ventilant trois choses par agent et par catégorie de robot : le nombre de requêtes, le temps passé à l’origine et le statut de cache. Deux sources suffisent, les journaux d’accès du serveur et, derrière Cloudflare, l’analytique GraphQL ; la question à laquelle répondre est quelle part du temps PHP de la journée sert des robots, et lesquels.
Les journaux d’accès
Le journal d’accès du serveur web porte tout ce qu’il faut : l’agent, la méthode, le chemin, le statut et, selon la configuration, le temps de réponse. Trois comptages donnent l’essentiel : les requêtes par heure et par agent, la part des POST (un robot ne devrait presque jamais en faire), et les requêtes sur les chemins non cachables, panier, compte, recherche interne, admin-ajax.php. La commande ci-dessous, au format combiné d’Apache et nginx, isole les agents qui frappent ces chemins.
# Requêtes par agent sur les chemins non cachables, journal au format combiné (Apache, nginx).
# Découpage sur les guillemets : $2 = « MÉTHODE chemin protocole », $6 = agent.
awk -F'"' '
  $2 ~ /(cart|panier|checkout|commander|my-account|mon-compte|admin-ajax|wc-ajax|[?]s=)/ {
    split($2, req, " ")               # req[1] = méthode, req[2] = chemin
    agent = $6
    # Nom du robot quand l agent en déclare un (GPTBot, meta-externalagent…), sinon premier mot
    if (match(agent, /[A-Za-z0-9._-]*([Bb]ot|[Cc]rawler|[Ss]pider|externalagent|externalhit|[Ff]etcher)[A-Za-z0-9._-]*/))
      agent = substr(agent, RSTART, RLENGTH)
    else
      sub(/ .*/, "", agent)
    compte[agent " " req[1]]++
  }
  END { for (k in compte) printf "%8d %s\n", compte[k], k }
' access.log | sort -rn | head -20

# Le même robot, heure par heure (champ 4 = [jj/Mmm/aaaa:hh)
grep -i 'meta-externalagent' access.log | awk '{print substr($4, 2, 14)}' | uniq -c
Commande vérifiée le 15 octobre 2026 sur sept jours de journal nginx au format combiné, avec gawk, mawk, BSD awk et busybox. Le premier mot de l’agent ne suffit pas à trier : GPTBot, ClaudeBot, meta-externalagent, bingbot et Amazonbot commencent tous par Mozilla/5.0, et sur ce journal une version naïve rangeait 1 093 requêtes sous ce seul mot. Derrière Cloudflare, le premier champ porte l’adresse du proxy, pas celle du visiteur.
Un robot qui apparaît dans ce classement avec des POST, ou avec des centaines de requêtes par heure sur le panier, est le premier suspect. Le temps de réponse, quand le journal le porte (%D sous Apache, $request_time sous nginx), permet de passer du nombre de requêtes au temps d’origine réellement consommé par chaque agent, la mesure qui compte.
L’analytique GraphQL de Cloudflare
Derrière Cloudflare, le jeu de données httpRequestsAdaptiveGroups ventile les requêtes par agent, par statut de cache et par catégorie de robot vérifié, avec le temps moyen passé à l’origine. Il est échantillonné, donc les comptes sont des estimations, mais les proportions sont fiables, et c’est la seule source par requête sur un plan Pro. La requête ci-dessous isole, sur sept jours, les agents qui atteignent l’origine en dynamic ou miss sur du HTML.
# Requête GraphQL (POST https://api.cloudflare.com/client/v4/graphql, jeton « Analytics : Read »)
# Agents qui atteignent l'origine sur du HTML : requêtes, statut de cache, temps d'origine moyen.
{
  viewer {
    zones(filter: { zoneTag: "<identifiant de zone>" }) {
      agents: httpRequestsAdaptiveGroups(
        limit: 50
        filter: {
          datetime_geq: "2026-10-08T00:00:00Z"
          datetime_lt:  "2026-10-15T00:00:00Z"
          edgeResponseContentTypeName: "html"
          cacheStatus_in: ["dynamic", "miss", "expired", "bypass"]
        }
        orderBy: [count_DESC]
      ) {
        count
        avg { originResponseDurationMs }      # temps passé à l'origine, en ms
        dimensions {
          userAgent                           # agent déclaré
          clientRequestHTTPMethodName         # GET ou POST
          cacheStatus
        }
      }
    }
  }
}
Requête vérifiée le 15 octobre 2026 sur une zone en offre gratuite, fenêtre de sept jours acceptée. La première ligne de la réponse portait un agent vide : les requêtes sans User-Agent forment un groupe à part, à traiter comme des robots, puisqu’aucun navigateur n’en envoie.
Le produit du nombre de requêtes par le temps d’origine moyen donne, agent par agent, les secondes de PHP consommées. Sur la boutique WooCommerce de septembre 2026, ce calcul donnait au robot de Meta plus des deux tiers du HTML calculé par l’origine, alors qu’il ne représentait que la moitié des requêtes : ses pages étaient les plus chères, parce qu’aucune n’était en cache.
Distinguer un vrai robot d’un faux agent
N’importe quel script peut se déclarer Googlebot. Chaque opérateur sérieux publie un moyen de vérification : Google demande une résolution DNS inverse en *.googlebot.com suivie d’une résolution directe qui rend la même adresse, Apple fait de même en *.applebot.apple.com, Meta renvoie aux routes de son système autonome AS32934, OpenAI, Anthropic, Perplexity et Amazon publient des listes d’adresses au format JSON. Derrière Cloudflare, la catégorie robot vérifié fait ce contrôle pour vous, par adresse IP ou par signature. Un agent qui se dit Googlebot depuis une adresse d’hébergeur ordinaire est un faux, à bloquer sans état d’âme.
Une troisième méthode se met en place : Web Bot Auth, des signatures cryptographiques posées dans les en-têtes HTTP, que le site vérifie avec la clé publique que le robot publie sous /.well-known/http-message-signatures-directory. Cloudflare l’utilise déjà, sur la base de deux brouillons IETF (draft-meunier-web-bot-auth-architecture et draft-meunier-http-message-signatures-directory) qui, au 8 octobre 2026, restent des brouillons ; la vérification par DNS ou par liste d’adresses reste nécessaire pour les opérateurs qui ne signent pas.
Votre site est-il aussi rapide que vos visiteurs l’espèrent ?
Entraînement, recherche, agent : quels robots laisser passer ?
La décision appartient à l’éditeur et dépend du modèle du site. Convention de l’agence : un site vitrine ou corporate laisse tout passer, parce qu’il gagne à être cité ; un média, dont le contenu est le produit, bloque les robots d’entraînement et n’interdit jamais les robots d’inférence, recherche et requêtes d’utilisateurs, qui lui renvoient des lecteurs.
Trois familles, et des jetons par opérateur
Les opérateurs documentent désormais leurs robots par finalité, et Cloudflare a repris la même grille en trois catégories le 1er juillet 2026 : recherche (indexer pour répondre plus tard et renvoyer du trafic), agent (agir en temps réel pour une personne) et entraînement (collecter pour entraîner ou affiner un modèle). Le tableau ci-dessous reprend les jetons publiés par chaque opérateur, vérifiés le 15 octobre 2026 ; ces listes bougent, et la page de l’opérateur fait foi le jour où vous écrivez votre fichier.
| Opérateur | Entraînement | Recherche | Action d’un utilisateur | Vérification |
|---|---|---|---|---|
| OpenAI | GPTBot | OAI-SearchBot | ChatGPT-User (robots.txt peut ne pas s’appliquer) | Listes d’adresses JSON |
| Anthropic | ClaudeBot | Claude-SearchBot | Claude-User | Liste d’adresses JSON |
| Meta | meta-externalagent | meta-webindexer | meta-externalfetcher (peut ignorer robots.txt) | Routes de l’AS32934 |
| Perplexity | Aucun déclaré | PerplexityBot | Perplexity-User (ignore robots.txt) | Listes d’adresses JSON |
| Amazon | Amazonbot (peut servir à l’entraînement) | Amzn-SearchBot | Amzn-User (peut ne pas suivre toutes les règles) | Listes d’adresses |
| Apple | Applebot-Extended (jeton d’usage, n’explore pas) | Applebot | Aucun déclaré | DNS inverse *.applebot.apple.com |
Google-Extended (jeton d’usage, sans agent propre) | Googlebot | Aucun déclaré | DNS inverse *.googlebot.com | |
| Common Crawl | CCBot | Aucun | Aucun | Aucune |
Deux jetons se lisent de près. Applebot-Extended n’explore aucune page : il indique seulement à Apple de ne pas utiliser pour l’entraînement ce qu’Applebot a collecté, sans effet sur Siri ni sur le classement. Google-Extended est du même type, sans agent propre : il refuse l’usage du contenu pour entraîner les modèles Gemini et pour l’ancrage de leurs réponses dans l’index, et Google précise qu’il ne change rien à la présence dans la recherche.
Les robots déclenchés par un utilisateur (ChatGPT-User, Perplexity-User, meta-externalfetcher, Amzn-User) préviennent qu’ils peuvent passer outre robots.txt, puisqu’une personne a demandé la page : leur charge ne se règle qu’au pare-feu.
Le cas Google
Googlebot alimente à la fois la recherche classique et les réponses générées (AI Overviews, AI Mode), avec un seul robot et un seul jeton. Au 15 octobre 2026, Google ne propose pas de réglage qui retire un site des résumés générés tout en le gardant dans les résultats classiques ; les seuls leviers documentés sont ceux des extraits (nosnippet, data-nosnippet, max-snippet), qui limitent aussi l’affichage ordinaire. Bloquer Googlebot pour échapper aux résumés revient donc à sortir de la recherche Google, un arbitrage qui appartient à l’éditeur.
Le cadre bouge. Au Royaume-Uni, l’autorité de la concurrence (CMA) a imposé à Google, le 3 juin 2026, une obligation de conduite envers les éditeurs : des contrôles effectifs sur l’usage de leur contenu dans les fonctions d’IA générative de la recherche, sans pénalité dans les résultats classiques. L’avis de la CMA fixe l’entrée en vigueur au 3 décembre 2026, pour les réponses montrées au Royaume-Uni ; l’effet sur les réglages offerts ailleurs reste à observer.
Déclarer une préférence : Content-Signal
La directive Content-Signal, placée dans un groupe User-agent du robots.txt, déclare pour quels usages le contenu peut être collecté : search (index et résultats faits de liens et d’extraits, sans résumé généré), ai-input (injection en temps réel dans un modèle au moment de la réponse) et ai-train (entraînement ou affinage). Elle complète les Disallow par robot sans les remplacer : les jetons changent avec les opérateurs, la préférence déclarée reste stable.
Son statut appelle de la prudence. Le vocabulaire vient d’un brouillon IETF rédigé par deux auteurs de Cloudflare, dont la dernière révision date du 1er octobre 2025 et qui est aujourd’hui expiré ; le travail sur un vocabulaire de préférences se poursuit au groupe de travail AIPREF. C’est une préférence déclarée, sans valeur de standard ni contrainte technique.
La portée juridique est une position de Cloudflare : sa documentation du robots.txt géré présente un no comme une réserve expresse de droits au titre de l’article 4 de la directive européenne 2019/790 sur la fouille de textes et de données. Un éditeur qui s’appuie dessus s’appuie sur une interprétation, qu’aucune décision de justice n’a encore confirmée.
Cloudflare fait d’ailleurs évoluer sa mécanique. Depuis le 15 septembre 2026, le robots.txt géré est déprécié au profit de Bot Preference Sync, disponible sur tous les plans, qui réécrit le robots.txt du site à partir des réglages du tableau de bord, en tête du fichier existant et en conservant les Disallow déjà présents. Un fichier maîtrisé à l’origine se passe de ce service, et un cumul des deux produirait deux groupes * portant deux préférences.
Un robots.txt type pour un média
Le fichier ci-dessous applique la convention média : préférence déclarée, robots d’entraînement bloqués, robots d’inférence autorisés explicitement. Un groupe propre à un robot remplace pour lui le groupe *, d’où la répétition de la préférence et des exclusions dans le groupe des robots autorisés. Sur WordPress, le fichier est virtuel et s’écrit par le filtre robots_txt ; sur un autre serveur, un fichier physique à la racine fait le même travail, comme pour les règles décrites dans notre guide du fichier .htaccess.
# robots.txt d'un site de type média (convention agence, jetons vérifiés le 15 octobre 2026)
User-agent: *
Content-Signal: search=yes, ai-input=yes, ai-train=no
Disallow: /wp-admin/
Disallow: /?s=
Disallow: /recherche/
Allow: /wp-admin/admin-ajax.php

# Robots d'entraînement : bloqués
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: CCBot
User-agent: Applebot-Extended
User-agent: meta-externalagent
User-agent: Amazonbot
Disallow: /

# Robots de recherche et d'action d'un utilisateur : autorisés, avec les mêmes exclusions que le groupe *
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
User-agent: Perplexity-User
User-agent: meta-webindexer
User-agent: meta-externalfetcher
User-agent: Amzn-SearchBot
User-agent: Amzn-User
Content-Signal: search=yes, ai-input=yes, ai-train=no
Disallow: /wp-admin/
Disallow: /?s=
Disallow: /recherche/
Allow: /

Sitemap: https://exemple.com/sitemap.xml
Le contrôle se fait sur le fichier réellement servi, robot par robot, avec l’analyseur de la bibliothèque standard de Python, qui applique la règle du groupe le plus spécifique comme le fait la RFC 9309. Un fichier modifié met jusqu’à 24 heures à être relu : la RFC 9309 recommande aux robots de ne pas garder une copie en cache au-delà, et Google documente la même durée, allongée si le fichier répond en erreur. Sur WordPress, le fichier virtuel est en cache comme une page : vider le cache de pages avant de purger le CDN, sinon l’edge reprend l’ancienne version.
# Contrôle du robots.txt servi, robot par robot (Python 3, bibliothèque standard)
import urllib.request, urllib.robotparser

site = "https://exemple.com"
contenu = urllib.request.urlopen(site + "/robots.txt").read().decode("utf-8")
p = urllib.robotparser.RobotFileParser()
p.parse(contenu.splitlines())

for agent in ["GPTBot", "ClaudeBot", "meta-externalagent",
              "OAI-SearchBot", "Claude-User", "PerplexityBot", "Googlebot"]:
    # True = la page peut être explorée par cet agent
    print(f"{agent:20s} {p.can_fetch(agent, site + '/un-article/')}")
Comment maîtriser la charge des robots au-delà du robots.txt ?
Au pare-feu, en bloquant les actions non cachables et en laissant les pages ouvertes. Le robots.txt est une demande : la RFC 9309 précise depuis septembre 2022 que ses règles ne sont pas une forme d’autorisation d’accès. Un robot qui exécute le JavaScript suit les liens d’action quoi qu’en dise le fichier ; seule une règle de pare-feu l’arrête.
Bloquer les actions, garder les pages
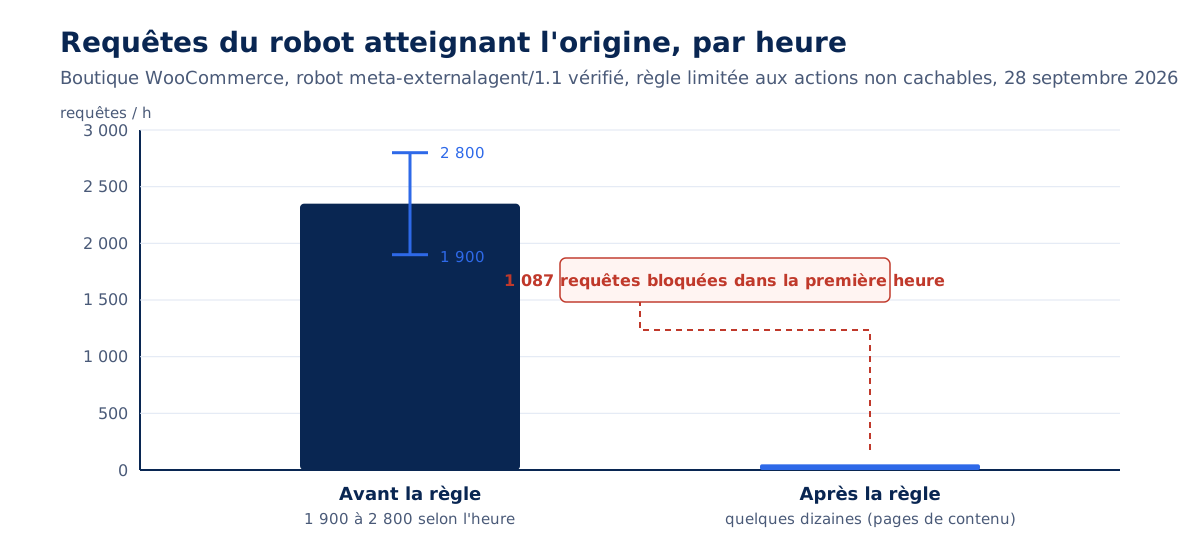
Sur la boutique WooCommerce auditée en septembre 2026, le robot meta-externalagent/1.1, vérifié par Cloudflare dans la catégorie « AI Crawler », produisait des centaines de milliers de requêtes par semaine sur panier/?remove_item=…, POST /?wc-ajax=… et POST /wp-admin/admin-ajax.php, avec autant de POST que de GET sur le site. Le robots.txt n’y pouvait rien : ces requêtes partaient du JavaScript des pages que le fichier autorisait. La règle de pare-feu Cloudflare ci-dessous ne bloque que les méthodes et chemins non cachables pour cet agent, et laisse les pages de contenu accessibles.
# Règle personnalisée Cloudflare, action « Block » (jamais « Challenge » : un défi casse les appels AJAX réels)
# Adapter les chemins aux slugs traduits du site (panier, commande, compte).
(lower(http.user_agent) contains "meta-externalagent")
and (
  not http.request.method in {"GET" "HEAD"}
  or http.request.uri.path contains "/wp-admin/"
  or http.request.uri.path contains "/panier" or http.request.uri.path contains "/cart"
  or http.request.uri.path contains "/commander" or http.request.uri.path contains "/checkout"
  or http.request.uri.path contains "/mon-compte" or http.request.uri.path contains "/my-account"
  or http.request.uri.query contains "wc-ajax" or http.request.uri.query contains "add-to-cart"
  or http.request.uri.query contains "remove_item" or http.request.uri.query contains "add_to_wishlist"
)
Mesure du 28 septembre 2026, relevée dans l’analytique Cloudflare de la boutique : 1 087 requêtes bloquées dans l’heure qui a suivi le déploiement, et un robot qui est passé d’environ 1 900 à 2 800 requêtes par heure à l’origine à quelques dizaines, celles des pages de contenu. Le TTFB d’origine est redescendu avec lui. La règle vaut pour n’importe quel robot qui exécute le JavaScript ; le jeton change, la logique reste.
Pourquoi bloquer plutôt que défier ? Un défi JavaScript de Cloudflare interrompt la requête par une page HTML que le navigateur doit afficher et résoudre ; un appel AJAX attend du JSON, reçoit cette page, échoue et ne réessaie pas. Sur un site de contenus mesuré en septembre 2026, un jeu de règles OWASP réglé en défi sur admin-ajax.php présentait environ 438 000 défis par jour à de vrais visiteurs, pour 14 résolus. Un défi sur une requête qui n’est pas une page équivaut à un blocage, et il touche les humains avant les robots.
Les réglages Cloudflare depuis juillet 2026
Depuis le 1er juillet 2026, tous les plans de Cloudflare, plan gratuit compris, règlent séparément les trois catégories de robots d’IA (recherche, agent, entraînement), avec trois options chacune : bloquer partout, bloquer sur les pages qui affichent de la publicité, ne pas bloquer. Cloudflare détecte automatiquement les pages avec publicité, sans documenter la méthode.
Depuis le 15 septembre 2026, pour les nouveaux domaines qui rejoignent Cloudflare, l’entraînement et les agents sont bloqués par défaut sur les pages avec publicité, la recherche restant autorisée. La note de version limite explicitement ce nouveau défaut aux domaines qui s’enregistrent, les clients existants pouvant le refuser avant la date. Des articles de presse ont annoncé une portée plus large ; le texte officiel ne la confirme pas.
Le point le plus lourd de conséquences concerne les robots mixtes. Depuis le 15 septembre 2026, un robot qui sert à la fois la recherche et l’entraînement, Googlebot, Bingbot ou Applebot, est traité selon l’ensemble de ses comportements : un blocage de l’entraînement le bloque aussi, donc sort le site de l’index. Pour éviter cet effet, Cloudflare a introduit le même jour un réglage « Disallow AI Training » qui publie la préférence dans le robots.txt via Bot Preference Sync, et son billet du 15 septembre donne deux ordres de grandeur utiles.
Moins de 1 % des sites Cloudflare choisissent de bloquer les robots de recherche.
Bryan Becker, Cloudflare, dans le billet Have it both ways: stay discoverable in search while disallowing AI training, publié le 15 septembre 2026
Dans le même billet, 17 % des sites activent un mécanisme de blocage de l’entraînement. La distinction entre les deux familles est donc déjà la pratique majoritaire chez ceux qui règlent quelque chose, et le blocage total reste marginal.
Les robots vérifiés passent les protections par défaut
La documentation Cloudflare explique pourquoi la règle ciblée est nécessaire : les robots vérifiés ont historiquement été exclus des configurations par défaut, tous plans confondus, et Super Bot Fight Mode les laisse passer. Un robot d’IA vérifié qui exécute le panier n’est donc arrêté ni par la protection contre les robots, ni par un filtrage sur le score. Il faut le nommer dans une règle : un robot légitime est aussi celui que vos protections laissent entrer.
Sans Cloudflare : nginx, Apache, fail2ban
Sans CDN devant le site, le serveur web porte la règle. Sous nginx, un map sur l’agent attribue une clé de limitation aux seuls robots visés, et limit_req borne leur débit sur les chemins coûteux, en répondant 429 au-delà ; le reste du trafic n’a pas de clé, donc aucune limite. Sous Apache, une directive RewriteCond sur %{HTTP_USER_AGENT} et sur le chemin renvoie 403 sur les mêmes actions. Avec ou sans CDN (notre article sur les avantages et inconvénients d’un CDN aide à trancher), la règle vise les actions, jamais les pages.
# nginx : limiter le débit des robots d'IA sur les actions non cachables (contexte http puis server)
map $http_user_agent $robot_ia {
    default                           "";          # pas de clé : aucune limite
    ~*(GPTBot|ClaudeBot|meta-externalagent|Amazonbot|CCBot)  $binary_remote_addr;
}
limit_req_zone $robot_ia zone=robots_ia:10m rate=10r/m;   # 10 requêtes par minute et par adresse

server {
    # Les actions du panier et les appels AJAX : limitées pour les robots, intactes pour les visiteurs
    location ~ ^/(panier|cart|commander|checkout|mon-compte|my-account)/ {
        limit_req zone=robots_ia burst=5 nodelay;
        limit_req_status 429;
        try_files $uri $uri/ /index.php?$args;
    }
    location = /wp-admin/admin-ajax.php {
        limit_req zone=robots_ia burst=5 nodelay;
        limit_req_status 429;
        include fastcgi_params;   # puis la configuration PHP habituelle du site
    }
}
Vérifié le 15 octobre 2026 avec nginx 1.30.6 : sur 30 requêtes de GPTBot en 10 secondes vers le panier, 6 passent d’emblée (1 au débit nominal et 5 de rafale), une septième au bout de 6 secondes, quand nginx libère une place, et les 23 autres reçoivent un 429. Les 30 requêtes d’un navigateur passent toutes, et la limite s’applique aussi au POST sur admin-ajax.php.
Une précaution sur les serveurs équipés de fail2ban, Plesk en particulier : une prison qui bannit sur le volume de requêtes ou de 404 finit par bannir les robots de recherche, qui produisent les deux. Google publie ses plages d’adresses par catégorie (common-crawlers.json, special-crawlers.json), à mettre en confiance et à resynchroniser chaque semaine ; sa liste générale goog.json contient aussi les plages louées aux clients de Google Cloud, et la mettre en confiance exempte toute machine louée chez Google.
Comment rendre le crawl moins coûteux ?
En réduisant le nombre d’URL que le serveur doit calculer, et en rendant les autres cachables. Un robot qui ne trouve que des pages en cache et aucun lien d’action coûte quelques millisecondes par requête, quel que soit son volume. Cinq chantiers suffisent, et le premier, les actions en POST, règle à lui seul le cas WooCommerce.
Des actions en POST, jamais en lien GET
Un lien qui modifie le panier, qui vote ou qui se désinscrit se fait suivre par n’importe quel robot, et par les antivirus des messageries quand il est dans un courriel. La RFC 9110 définit GET et HEAD comme des méthodes sûres, précisément pour que les automates puissent les employer sans risque, et en tire une obligation : une action sélectionnée par un paramètre d’URL doit être désactivée quand on y accède par une méthode sûre.
Une action se déclenche donc par un bouton dans un formulaire POST, avec un jeton ; un lien ne fait qu’afficher une question. Sur WooCommerce, cela passe par le retrait des liens ?add-to-cart= des archives et par des boutons de formulaire à la place des liens d’action.
Fermer les espaces infinis
La recherche interne, les combinaisons de filtres et les tris se ferment aux robots par Disallow dans le robots.txt, et par des liens de filtres que les robots ne suivent pas : un bouton qui construit l’URL en JavaScript, ou un lien en rel="nofollow" pour les moteurs qui le respectent. Ce qu’un robot ne peut pas découvrir ne coûte rien.
Sur PrestaShop, le cœur ignore les actions de panier des robots qu’il reconnaît par leur agent, mais sa liste, même étendue dans la version 9.2, ne contient pas meta-externalagent : le pare-feu reste nécessaire. Notre comparatif des CMS pour un site performant revient sur ces différences de conception entre plateformes.
Normaliser la clé de cache et cacher les erreurs
Au CDN, la clé de cache ignore les paramètres qui ne changent pas la page (paramètres de campagne, identifiants de clic comme fbclid ou gclid), de sorte qu’un robot qui suit des liens décorés tombe sur la version en cache. Les réponses 404 et 410 se mettent en cache quelques minutes : une URL fantôme n’est alors calculée qu’une fois, puis servie depuis l’edge aux passages suivants.
Les fichiers statiques absents se traitent au serveur web (try_files $uri =404;) sans réveiller l’application. Sur un site mesuré en septembre 2026, une image de fond supprimée mais encore référencée par le CSS faisait télécharger à sa place une page 404 complète de 49 Ko sur 32 fiches.
Un sitemap à jour et des directives que les robots lisent
Un sitemap qui ne liste que des URL canoniques en 200 évite aux robots de découvrir le site par ses pages de tags et ses paginations. La directive Crawl-delay, souvent recommandée pour ralentir un robot, est ignorée par Google, qui ne lit que user-agent, allow, disallow et sitemap ; Apple et Amazon l’ignorent aussi, Anthropic déclare la respecter. Elle garde un intérêt pour les outils SEO qui la lisent, et presque aucun pour la charge des robots d’IA. Le lien entre crawl, vitesse et référencement est traité dans notre article sur l’impact SEO de la webperf.
Préchargement du cache : un robot de plus
Les extensions de cache proposent de précharger les pages après chaque purge, pour que le premier visiteur trouve une version prête. Ce préchargement est un crawl complet du site, lancé par le serveur lui-même (l’agent WP Rocket/Preload part de l’adresse du serveur) : une purge à chaque publication sur un site de 20 000 pages déclenche 20 000 recalculs. Limiter la fréquence des purges et précharger les seules pages populaires évite de s’infliger la charge qu’on reproche aux robots ; la stratégie est détaillée dans notre guide du cache.
Par où commencer ?
Par une mesure, puis une décision, puis une règle. Mesurer la part des robots dans le temps d’origine sur sept jours ; décider avec l’éditeur de la politique d’entraînement selon le modèle du site ; bloquer au pare-feu les actions non cachables des robots qui exécutent le JavaScript ; puis surveiller la ventilation par catégorie de robot à chaque passe de maintenance.
Cet ordre évite les deux erreurs les plus fréquentes : écrire un robots.txt et croire le problème réglé, alors que le fichier ne gouverne que les robots qui le lisent et jamais les actions déclenchées par le JavaScript ; ou bloquer large au pare-feu, défis compris, et casser les appels AJAX des vrais visiteurs tout en sortant le site de l’index. Entre les deux, une règle étroite sur des actions précises, mesurée avant et après, fait l’essentiel du travail.
La charge des robots est l’un des postes que nous suivons dans l’hébergement infogéré des sites que nous gérons, parce qu’elle se dégrade seule, au rythme où de nouveaux opérateurs apparaissent. Un monitoring de performance qui suit le TTFB terrain signale une dérive en quelques jours, et un audit de performance la chiffre quand elle est déjà là. La question de départ reste la même : quelle part de votre serveur travaille pour des humains ?