Une campagne Google Ads envoie du trafic vers votre landing page. Chaque visiteur arrive avec un identifiant gclid unique collé à l’URL, et aucun d’entre eux ne touche le cache : chaque requête file jusqu’à l’origine, page régénérée à froid, avec le pire TTFB du site. Le paradoxe se résume en une phrase : le trafic le plus cher reçoit la pire expérience.
La cause tient à un détail que peu d’équipes regardent : pour tous les caches de la chaîne, deux URL identiques à un ?utm_source= près sont deux ressources distinctes. Chaque campagne fabrique donc des entrées de cache neuves pour un contenu déjà stocké, et cette fragmentation silencieuse divise le taux de hit sans déclencher la moindre alerte.
Ce guide reprend le sujet là où les articles SEO l’abandonnent : la clé de cache, sa mesure, les correctifs à chaque étage, et le nouvel en-tête No-Vary-Search qui vient de passer du laboratoire Chromium au multi-moteurs avec Firefox 154. Une question guide l’ensemble : combien de fois payez-vous la même page ?
Pourquoi une même page devient-elle plusieurs ressources différentes ?
Un cache compare chaque requête entrante à ce qu’il détient déjà au moyen d’une clé, et cette clé porte par défaut sur l’URL entière, query string comprise. Les adresses /article et /article?utm_source=newsletter sont donc deux objets distincts : contenu identique, stockage doublé, taux de hit divisé.
Le comportement n’a rien d’un défaut d’implémentation, c’est de la prudence : un paramètre peut changer la réponse, alors le cache traite chaque variante comme une page à part. Chez Cloudflare, la clé de cache par défaut se compose de l’hôte, du chemin et de la query string complète, si bien que /promo.jpg?utm_campaign=printemps et /promo.jpg?utm_campaign=automne occupent deux emplacements distincts au niveau de l’edge pour le même fichier binaire.
L’effet est combinatoire, pas additif. Un site de 100 000 URL dont chaque adresse circule avec quatre variantes de paramètres manipule 400 000 clés pour le même contenu, et chaque variante repart de zéro : son premier visiteur paie la régénération complète, celle-là même que le cache à tous les étages était censé éviter. La mémoire partagée entre visiteurs se dilue à mesure que les campagnes se multiplient.
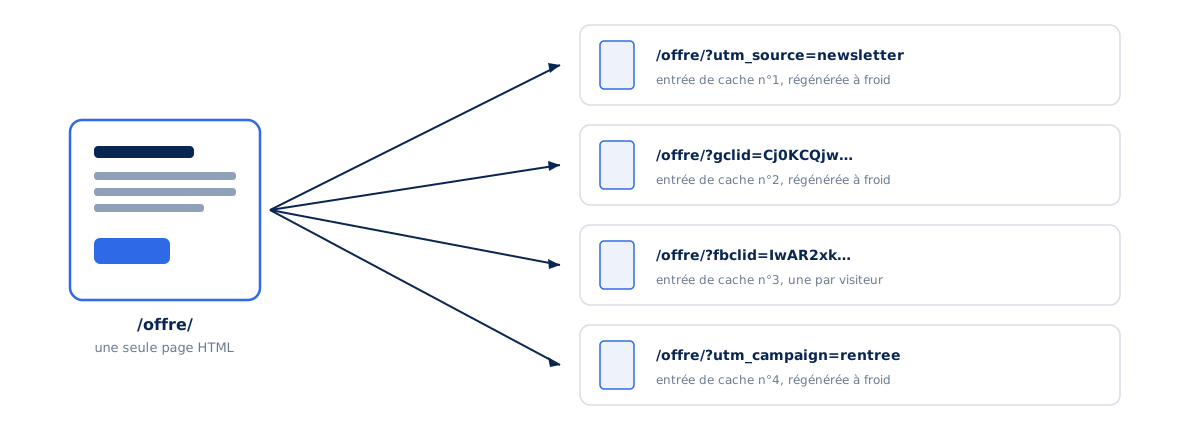
Le pire élève du lot mérite d’être nommé : fbclid. Facebook l’ajoute à chaque clic sortant, y compris sur les partages organiques et les liens en commentaire, avec une valeur unique par clic. Une page virale sur Facebook, c’est autant d’entrées de cache que de visiteurs, sans qu’aucun budget publicitaire ne soit en jeu : fbclid fait plus de dégâts que toutes les UTM réunies, et il annonce la question suivante, celle de l’inventaire.
Quels paramètres fragmentent-ils le cache ?
Tous les paramètres de tracking, soit plusieurs dizaines de noms recensés rien que dans la liste d’exclusion par défaut de WP Rocket : la famille utm_ complète, gclid et ses successeurs gbraid et wbraid, fbclid, msclkid, ttclid. Le tableau suivant regroupe les familles à connaître par régie.
| Famille | Paramètres |
|---|---|
| Google Analytics et Ads | utm_source, utm_medium, utm_campaign, utm_term, utm_content, utm_id, _ga, _gl, gclid, gbraid, wbraid, gad_source |
| fbclid, fbadid, fb_action_ids, fb_source | |
| Autres régies | msclkid (Microsoft Ads), ttclid (TikTok), yclid (Yandex), li_fat_id (LinkedIn) |
| Adobe | ef_id (Advertising Cloud), s_kwcid (Analytics) |
| Emailing et affiliation | mc_cid et mc_eid (Mailchimp), dm_i (Dotdigital), vgo_ee (ActiveCampaign), sscid (ShareASale) |
La référence la mieux tenue à jour reste la liste que WP Rocket ignore par défaut, enrichie régulièrement, les ajouts récents gbraid, wbraid et gad_source en témoignent. S’y ajoutent selon les sites les paramètres de call tracking, ceux des extensions WordPress comme cn-reloaded ou age-verified, et les identifiants propres à chaque outil d’emailing : l’écosystème en produit plus vite qu’on ne les recense.
Le point de méthode compte davantage que la liste elle-même : elle ne se recopie pas, elle s’établit site par site. L’inventaire distingue les paramètres qui changent la réponse, comme page, s, id, lang, variant ou orderby, de ceux qui ne la changent jamais, et applique une règle unique aux cas limites : tout paramètre ambigu reste dans la clé. Reste à savoir où, physiquement, cette clé se calcule.
À quels étages de la chaîne le problème se pose-t-il ?
À quatre étages au moins : le cache disque du navigateur, le cache de préchargement des Speculation Rules, l’edge du CDN et le cache applicatif du serveur. Chacun calcule sa propre clé, chacun se corrige séparément, et le maillon le moins bien réglé commande l’expérience finale.
| Étage | Clé par défaut | Où agir |
|---|---|---|
| Cache disque du navigateur | URL complète | No-Vary-Search (Chrome 141+, Firefox 154+) |
Prefetch et prerender (Speculation Rules) | URL complète | No-Vary-Search (Chrome 121+) et expects_no_vary_search |
| CDN / edge | Hôte + chemin + query string | Cache Rules, Transform Rules, clé personnalisée |
| Cache applicatif (WP Rocket, LiteSpeed, FastCGI, Varnish) | Variable selon l’outil | Configuration du plugin ou du serveur |
| bfcache | Hors périmètre | No-Vary-Search sans aucun effet |
La lecture verticale du tableau est la bonne : corriger un étage ne corrige pas les autres. Un CDN à la clé parfaitement réglée n’empêche pas le navigateur de re-télécharger une page qu’il détient déjà sous une autre query string, et inversement. Chaque étage se traite avec ses propres outils, dans l’ordre où le trafic les traverse, et les variantes stockées en périphérie du réseau pèsent d’autant plus que le taux de hit conditionne directement le TTFB de la première visite.
Un préalable annule tout le raisonnement s’il manque : le HTML doit être cachable. Une page servie avec Cache-Control no-store ne bénéficie d’aucun des correctifs de cet article, puisque aucun cache n’a le droit de la stocker : vérifier la cachabilité vient avant tout réglage de clé, et cette vérification commence par la mesure.
Comment mesurer la fragmentation sur son propre site ?
Trois instruments suffisent : les logs serveur pour inventorier les paramètres reçus, le taux de hit du CDN segmenté avec et sans query string, et les DevTools pour vérifier au cas par cas. Un point est contre-intuitif : CrUX ne montrera jamais le problème, par construction.
L’inventaire commence côté serveur. Une ligne de commande extrait les noms de paramètres du log d’accès et les trie par fréquence, ce qui donne en quelques secondes la liste réelle, pas la liste supposée :
# Top 40 des parametres recus, tries par frequence
awk '{print $7}' access.log | grep '?' | cut -d'?' -f2 \
  | tr '&' '\n' | cut -d'=' -f1 | sort | uniq -c | sort -rn | head -40
Côté CDN, le taux de hit segmenté raconte l’histoire complète : des URL sans paramètre à 90 % de hit et des URL paramétrées proches de zéro signent la fragmentation. Dans les DevTools, la colonne Size du panneau réseau confirme au cas par cas, en comparant une visite avec et sans paramètre. Le débogage de No-Vary-Search, lui, se fait encore à l’ancienne : aucune intégration DevTools n’existe à ce jour, une limite que Harry Roberts regrette publiquement dans son article de référence.
Ne cherchez pas le problème dans PageSpeed Insights ni dans le rapport Core Web Vitals de la Search Console. La méthodologie CrUX retire les paramètres de requête et les fragments des URL, précisément pour agréger toutes les expériences d’une même page : le TTFB dégradé du trafic payant est bien dans les données, mais noyé dans la moyenne, comme l’explique notre comparatif entre données terrain et données laboratoire. Seul un RUM qui ne normalise pas les URL, ou le taux de hit lui-même, rend le phénomène visible : l’invisibilité dans les outils standards explique sa longévité.
Qu’est-ce que l’en-tête No-Vary-Search et comment l’écrire ?
No-Vary-Search est un en-tête de réponse HTTP qui déclare quelles parties de la query string peuvent être ignorées lors de la correspondance de cache. Documenté sur MDN et standardisé à l’IETF dans le draft httpbis no-vary-search, il permet au cache de réutiliser une ressource déjà stockée malgré des paramètres différents.
La confusion avec Vary est fréquente et mérite d’être levée d’emblée. Vary déclare que la réponse dépend d’en-têtes de requête comme Accept-Encoding, et ajoute donc des variantes ; No-Vary-Search déclare que la réponse ne dépend pas de certains paramètres d’URL, et en supprime. Les deux en-têtes agissent sur la même clé, dans deux directions opposées. Ses cinq formes s’écrivent en structured fields, la syntaxe de la RFC 8941, avec des listes entre parenthèses et des valeurs entre guillemets :
# L'ordre des parametres n'est plus discriminant
No-Vary-Search: key-order

# Tous les parametres sont ignores
No-Vary-Search: params

# Seuls ces parametres sont ignores (liste noire)
No-Vary-Search: params=("utm_source" "utm_medium" "gclid" "fbclid")

# Tout est ignore sauf ces parametres (liste blanche)
No-Vary-Search: params, except=("q" "page")

# Combinaison
No-Vary-Search: key-order, params, except=("id")
Le choix entre les deux formes principales est un choix de posture. La forme except=() ignore tout sauf les paramètres fonctionnels déclarés : elle convient à un site dont on connaît exhaustivement les paramètres consommés par le serveur. La forme params=() explicite ne retire de la clé que les paramètres nommés : c’est la posture prudente partout ailleurs, car la liste blanche protège des paramètres qu’on a oubliés, quand la liste noire les laisse fragmenter. L’envoi de l’en-tête, lui, tient en une ligne côté serveur :
# Apache (.htaccess ou vhost)
Header set No-Vary-Search "params=(\"utm_source\" \"utm_medium\" \"utm_campaign\" \"gclid\" \"fbclid\")"

# Nginx
add_header No-Vary-Search 'params=("utm_source" "utm_medium" "utm_campaign" "gclid" "fbclid")' always;
Sur Apache, la directive rejoint les en-têtes déjà posés dans votre fichier de configuration à la racine, avec les précautions de périmètre qui s’y appliquent. Encore faut-il savoir quels navigateurs honorent réellement cette déclaration aujourd’hui.
Quel est son niveau de support aujourd’hui ?
Meilleur qu’il y a un an, et désormais multi-moteurs : Chrome l’applique au cache de préchargement depuis la version 121 et au cache disque HTTP depuis la version 141, Firefox l’active par défaut depuis la version 154 d’août 2026, et WebKit n’a pas de position officielle. La limite structurante est ailleurs : aucun CDN ne l’interprète encore dans sa clé de cache.
Côté Chromium, le déploiement s’est fait en trois temps : le cache de prefetch des Speculation Rules en janvier 2024 avec Chrome 121, le prerender ensuite, puis le cache disque général avec Chrome 141 en septembre 2025 sur desktop, la disponibilité Android ayant suivi autour de la version 144. Mozilla a confirmé la trajectoire avec un intent to ship positif puis une activation par défaut dans Firefox 154, publiée le 18 août 2026 : l’en-tête est passé d’une curiosité Chromium à une vraie fonctionnalité multi-moteurs en moins d’un an.
La nuance qui empêche de crier victoire concerne l’edge. Les auteurs de la spécification représentent Fastly, Akamai et Cloudflare, mais aucun de ces CDN n’intègre aujourd’hui No-Vary-Search dans le calcul de sa clé de cache : l’en-tête agit sur le navigateur, pas sur la périphérie, et la normalisation côté CDN reste entièrement manuelle.
Le déploiement ne comporte en revanche aucun risque de régression : un cache qui ne comprend pas l’en-tête l’ignore et retombe sur la comparaison exacte des URL, le comportement historique. Poser l’en-tête aujourd’hui améliore les navigateurs récents sans rien dégrader ailleurs, ce qui en fait une amélioration progressive au sens strict, en attendant que l’edge suive.
Votre site est-il aussi rapide que vos visiteurs l’espèrent ?
Que faire en attendant côté CDN ?
Trois approches existent chez tous les grands CDN, de la plus propre à la plus radicale. Chez Cloudflare, elles passent par les Cache Rules et les Transform Rules, disponibles jusque sur le plan gratuit pour la seconde :
- personnaliser la clé de cache en excluant les paramètres de tracking, l’URL restant intacte de bout en bout ;
- retirer les paramètres avant le cache via une Transform Rule, l’URL vue par le visiteur restant inchangée, seule celle envoyée à l’origine étant nettoyée ;
- ignorer toute la query string, à réserver aux chemins de ressources statiques, car sur du HTML cela casse la recherche interne, la pagination et les filtres.
La deuxième approche s’écrit en une expression, dans une règle URL Rewrite de type dynamique, grâce à la fonction remove_query_args() du langage de règles :
# Transform Rule > URL Rewrite > Query > Rewrite to... > Dynamic
remove_query_args(http.request.uri.query,
  "utm_source", "utm_medium", "utm_campaign", "utm_term",
  "utm_content", "utm_id", "gclid", "gbraid", "wbraid",
  "gad_source", "fbclid", "msclkid", "ttclid", "_ga", "_gl")
Un avertissement de la documentation Cloudflare mérite d’être repris tel quel : quand on personnalise la clé de cache en activant la normalisation d’URL, il faut aussi normaliser les URL envoyées à l’origine, faute de quoi la clé et la requête réellement servie divergent, ce qui ouvre la porte à un empoisonnement de cache par désalignement. La périphérie réglée, reste l’étage applicatif, WordPress en tête.
Et côté WordPress, comment reprendre la main ?
Les deux plugins de cache dominants ont des défauts opposés : WP Rocket ignore d’office les paramètres de tracking et sert le fichier de cache de l’URL propre, si bien que /about-us/?gclid=abc et /about-us/?gclid=def reçoivent la même page, tandis que LiteSpeed Cache met en cache chaque query string individuellement par défaut.
Sur LiteSpeed, le correctif se fait dans le réglage Drop Query String, en collant la liste des paramètres à écarter, un nom par ligne :
# LiteSpeed Cache > Cache > Drop Query String
utm_source
utm_medium
utm_campaign
utm_term
utm_content
gclid
gbraid
wbraid
fbclid
msclkid
L’envoi de No-Vary-Search depuis WordPress lui-même passe par le hook send_headers, en excluant les pages dont la réponse dépend du contexte, comme le panier, le compte ou la recherche :
// functions.php : envoyer No-Vary-Search sur les pages cachables
add_action('send_headers', function () {
    if (is_search() || is_cart() || is_checkout() || is_user_logged_in()) {
        return; // reponse dependante du contexte : ne rien declarer
    }
    header('No-Vary-Search: params=("utm_source" "utm_medium" "utm_campaign" "gclid" "fbclid")');
});
Sur un FastCGI cache Nginx ou un Varnish, la clé se définit directement dans la configuration, avec un piège documenté publiquement : la combinaison de paramètres. Une URL qui porte à la fois un fbclid et un paramètre fonctionnel doit sortir du cache ou conserver le paramètre fonctionnel dans sa clé, et une règle trop simple, écrite pour un paramètre isolé, la laisse passer : les règles se testent sur des URL combinées, jamais sur des cas d’école. Encore faut-il que la liste déclarée soit la bonne.
Que se passe-t-il si l’on se trompe de paramètre ?
Déclarer ignorable un paramètre que le serveur lit revient à servir un contenu erroné depuis le cache. Sur une page de compte, un panier ou une recherche interne, c’est une fuite de données entre visiteurs : l’erreur de déclaration est un incident de sécurité, pas un simple bug d’affichage.
La revue de sécurité menée pendant le développement côté Chrome l’a formulé sans détour : un réglage trop large de No-Vary-Search, combiné à des bugs côté serveur, peut permettre à un attaquant de contrôler le contenu affiché à l’utilisateur. Le risque est comparable à celui d’autres mécanismes qui personnalisent la réponse, mais il existe, et il justifie la prudence que Harry Roberts résume dans son guide de l’en-tête publié en mai 2026, où il ne recommande l’en-tête que pour les paramètres purement analytiques ou purement décoratifs :
Je préfère qu’on me serve la bonne page un peu plus lentement que la mauvaise page rapidement.
Harry Roberts, dans son article Better Browser Caching with No-Vary-Search, CSS Wizardry, mai 2026
La règle opérationnelle se formule en une phrase : un paramètre ne se déclare ignorable que si l’on a vérifié que le serveur ne le lit jamais, ni dans le PHP, ni dans un plugin, ni dans une règle de réécriture. En cas de doute, il reste dans la clé, et cette même discipline vaut pour l’objection marketing qui arrive immanquablement dès qu’on parle de nettoyer des paramètres.
Le nettoyage des paramètres casse-t-il l’attribution marketing ?
Non, à condition de choisir le bon traitement. Les outils d’analytics lisent les paramètres dans l’URL affichée par le navigateur, côté client : tant que cette URL reste intacte, l’attribution ne voit rien. Le tableau suivant distingue les trois traitements et leurs conséquences respectives.
| Traitement | URL vue par le visiteur | Attribution côté client |
|---|---|---|
| Exclusion du paramètre de la clé de cache | Inchangée | Intacte |
| Réécriture de l’URL envoyée à l’origine | Inchangée | Intacte côté navigateur, perdue dans les logs serveur |
Redirection 301 vers l’URL nettoyée | Modifiée | Cassée, avec la latence de la redirection en prime |
Les deux premières approches sont invisibles pour Google Analytics, qui lit document.location dans le navigateur, avant toute considération de cache. Seule la redirection casse l’attribution, et elle ajoute un aller-retour réseau complet dont le coût est détaillé dans notre guide des codes de statut HTTP : la 301 est le seul traitement à proscrire, et c’est précisément le premier que l’on trouve dans les tutoriels.
Une recommandation met tout le monde d’accord, marketing compris : ne jamais poser de paramètres UTM sur des liens internes. La pratique pollue le crawl, fabrique des variantes de cache, et surtout réécrit la campagne d’une session déjà en cours, ce qui fausse l’attribution au lieu de l’enrichir : le suivi de la navigation interne se fait par événements, jamais par paramètres. Le versant SEO du sujet mérite le même recadrage.
Quel est l’impact SEO réel des paramètres d’URL ?
Aucune pénalité n’existe : les duplications ordinaires liées aux paramètres déclenchent une consolidation, pas une sanction. Les vrais coûts sont la dilution du signal de lien entre variantes, le gaspillage de budget de crawl et le risque d’affichage de la version paramétrée dans les résultats.
La réponse standard tient en une balise : la canonique auto-référente vers l’URL propre, présente sur chaque page, qui indique aux moteurs quelle variante consolider. Les fausses bonnes idées font plus de dégâts que le problème : renvoyer un 404 sur les URL paramétrées ou les bloquer dans le robots.txt fait perdre le bénéfice des liens entrants qui pointent vers ces variantes, un mécanisme détaillé dans notre analyse de l’impact SEO de la webperf. Un réflexe hérité est aussi à corriger : l’outil de gestion des paramètres d’URL de la Search Console, encore cité par de nombreux guides, a été retiré par Google en avril 2022, jugé utile pour environ 1 % seulement des configurations : les guides qui le mentionnent encore datent.
Le sujet SEO est donc réel mais secondaire : il se règle avec une canonique bien posée, quand le sujet cache se règle à quatre étages. Il reste un terrain où les deux se rejoignent, celui du préchargement, où les paramètres ruinent un mécanisme entier s’ils ne sont pas déclarés.
Quel rapport avec les Speculation Rules ?
Un prefetch ou un prerender ne sert que si l’URL cliquée correspond exactement à l’URL préchargée, et un simple gclid suffit à provoquer le ratage : la page est prête, le navigateur la jette. No-Vary-Search est né dans ce contexte, avec Chrome 121, pour réutiliser une page préchargée malgré des paramètres différents.
Le mécanisme se complète côté règles avec le champ expects_no_vary_search, qui annonce au navigateur la valeur attendue de l’en-tête avant même que la réponse n’arrive : il peut ainsi décider d’attendre un prefetch en cours plutôt que de lancer une requête concurrente. Google Search s’en sert pour ses propres pages de résultats, avec un gain de latence significatif mesuré lors de ses expérimentations, documentées par Chrome for Developers. La règle s’écrit ainsi :
<script type="speculationrules">
{
  "prefetch": [{
    "urls": ["/offre/"],
    "expects_no_vary_search": "params=(\"utm_source\" \"gclid\" \"fbclid\")"
  }]
}
</script>
Une précaution ferme le chapitre, propre au prerender : la page a pu être prérendue avec d’autres paramètres, voire aucun. Au départ, location.href porte l’URL prérendue, et le navigateur la remplace par l’URL finale au moment de l’activation : tout JavaScript qui dépend des paramètres de requête, un script d’attribution au premier chef, ne doit s’exécuter qu’après l’activation de la page prérendue, une mécanique détaillée dans notre guide de la navigation instantanée par prerendering.
Nettoyer les paramètres : arbitrage ou évidence ?
Le nettoyage des paramètres n’oppose pas le marketing à la technique : bien fait, il ne coûte rien à l’attribution, et il rend au trafic payant l’expérience que son coût d’acquisition justifie. Il demande un inventaire, un réglage par étage, et la discipline de laisser dans la clé tout ce dont on n’est pas certain.
L’équation économique se pose en termes simples : chaque variante de cache inutile fait payer deux fois le même contenu, une fois pour l’acquisition du clic, une fois pour la régénération d’une page qui existait déjà en cache, avec à la clé un temps de réponse serveur dégradé précisément sur les visiteurs les plus chers. Les termes techniques croisés ici sont repris dans le langage de la webperf pour les équipes qui découvrent le sujet : la facture est double et parfaitement évitable.
Mesurer votre propre fragmentation, arbitrer les paramètres ambigus et déployer les correctifs sans casser l’attribution relève d’un diagnostic instrumenté, du log serveur au RUM. C’est le périmètre exact d’un audit de performance web, et la mise en œuvre celui d’une optimisation de performance menée étage par étage : la clé de cache y est désormais un chapitre au même titre que les images ou les polices.