Une équipe CRO lance un test sur la page d’accueil. La variante gagne deux points de conversion, tout le monde se félicite. Trois semaines plus tard, le rapport Core Web Vitals de la Search Console vire à l’orange : le LCP mobile est passé de 2,1 à 3,4 secondes, et personne ne fait le lien. Le coupable n’est pas le test lui-même, c’est le mécanisme qui le rend possible, celui qui masque la page pendant que l’outil décide quoi afficher.
Ce mécanisme porte un nom, l’anti-flicker, ou pré-masquage. Il consiste à rendre la page invisible dès le début du chargement, le temps que le script d’A/B testing se charge, tire au sort une variante et modifie le DOM, puis à lever le voile. Sans lui, le visiteur verrait l’original quelques dizaines de millisecondes avant la variante, ce que le jargon appelle flash of original content. Avec lui, le navigateur ne peint rien tant que la décision n’est pas prise, et le LCP en paie mécaniquement le prix.
Cet article établit d’où vient exactement ce retard, pourquoi il n’apparaît dans presque aucun classement d’outils, et pourquoi les valeurs par défaut des éditeurs le rendent bien plus lourd qu’il ne devrait l’être. Il montre aussi que la question n’est jamais anti-flicker oui ou non, mais sur quel périmètre, pendant combien de temps, pour quels tests. Combien de millisecondes votre outil d’A/B testing vous coûte-t-il réellement, et lesquelles sont évitables ?
Pourquoi un outil d’A/B testing ralentit-il l’affichage d’une page ?
Parce qu’il masque la page pendant qu’il décide quoi afficher. Pour éviter que le visiteur voie l’original avant la variante, l’outil applique une règle du type body { opacity: 0 } dès le début du chargement, et ne la lève qu’une fois la décision prise. Adobe Target, Optimizely et Wingify bornent cette attente entre 2 000 et 3 000 ms par défaut, et ce masquage retarde l’affichage de tout le contenu.
Le problème que l’anti-flicker résout
Un test A/B côté client fonctionne par substitution : le serveur envoie toujours la même page, et c’est un script dans le navigateur qui remplace un titre, une image ou un bouton par la variante. Entre le moment où le HTML est affiché et celui où le script a fini son travail, il existe une fenêtre pendant laquelle le visiteur voit l’original. Cette fenêtre, c’est le flicker. Elle n’est pas seulement désagréable visuellement, elle fausse l’expérience elle-même : une partie du groupe test a vu le contrôle, et son comportement n’est plus attribuable à la variante seule.
L’anti-flicker n’est donc pas un caprice d’éditeur. La documentation de Kameleoon résume la position du marché en indiquant que le flicker peut confondre les visiteurs et fausser significativement les résultats d’un test. C’est la condition de validité de l’expérience, et tout ce qui suit part de ce constat plutôt que de le contester.
La solution retenue par le marché
La réponse quasi unanime des éditeurs est de masquer la page entière jusqu’à la décision. Un petit script synchrone, placé en tête du <head>, injecte une feuille de style qui rend le <body> invisible, puis arme un minuteur de sécurité. Le snippet ci-dessous en donne la forme générique, commentée pour montrer les trois moments qui comptent, la pose, l’attente et la levée :
<script>
(function (d, css, delay) {
  // 1. Pose du masque : une feuille de style injectee avant tout rendu
  var s = d.createElement('style');
  s.id = 'ab-mask';
  s.textContent = css;
  d.head.appendChild(s);

  // 3. Levee du masque : appelee par l'outil des que la variante est appliquee
  var lift = function () {
    var n = d.getElementById('ab-mask');
    if (n) { n.parentNode.removeChild(n); }
  };
  window.__abLift = lift;

  // 2. Attente bornee : le filet de securite si l'outil ne repond pas
  setTimeout(lift, delay);
})(document, 'body { opacity: 0 !important }', 3000);
</script>
Ce script doit être synchrone et placé avant toute autre ressource, ce qui est exactement l’inverse de tout ce que l’on recommande par ailleurs pour réduire l’impact des JavaScript tiers sur la performance. L’exception est ici structurelle : un masque posé après le premier rendu ne masque rien. Optimizely va jusqu’à demander de placer son snippet en premier script du head, chargé de façon bloquante, et déconseille explicitement le chargement async ou defer parce qu’il augmente fortement les risques de flicker. Le blocage est le comportement nominal, pas une erreur d’intégration.
Ce que le visiteur voit pendant ce temps
Rien, ou plus exactement le fond de page. Les ressources se chargent, le DOM se construit, la mise en page est calculée, mais aucun pixel de contenu n’est affiché. Adobe précise dans sa documentation que le navigateur continue de rendre la page et de charger les CSS et les images sous un opacity: 0. Le travail est fait, il est simplement caché. Sur mobile et sur un réseau moyen, cette attente s’ajoute à toutes les autres : au TTFB, au téléchargement des polices, au décodage de l’image principale. Et c’est précisément là que la mesure du LCP intervient.
Comment l’anti-flicker dégrade-t-il le LCP ?
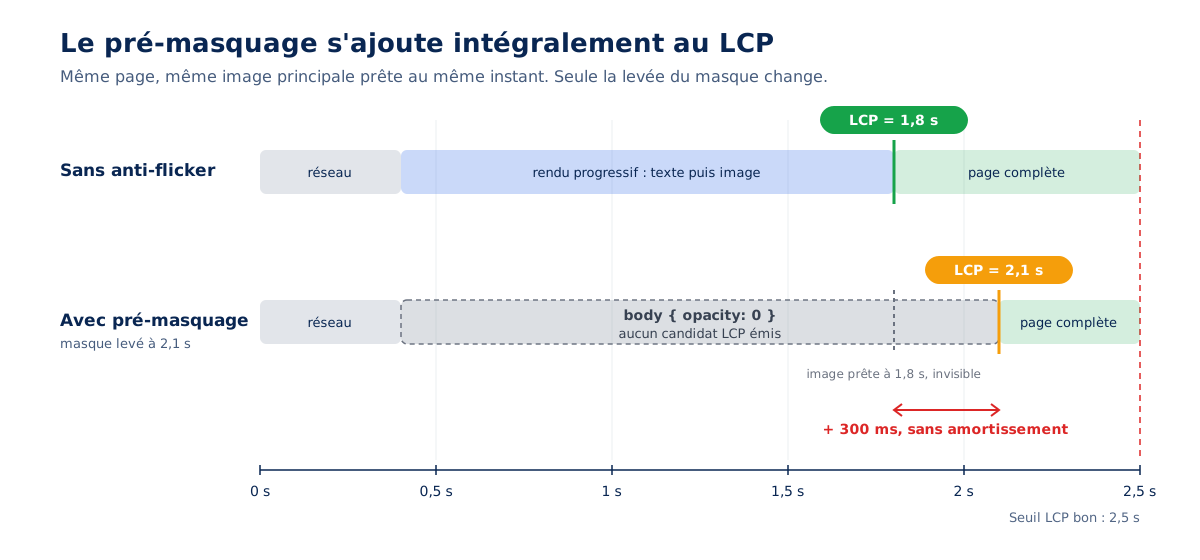
De façon directement proportionnelle. Un élément dont l’opacité vaut zéro est explicitement exclu des candidats au LCP par Chrome, depuis un changement d’août 2020 : tant que le masque est en place, le navigateur ne retient aucun candidat. Trois cents millisecondes de pré-masquage ajoutent donc trois cents millisecondes de LCP, sans amortissement, quelle que soit la vitesse du reste de la page.
Un élément invisible n’est pas un candidat
La définition du Largest Contentful Paint sur web.dev est sans ambiguïté : les navigateurs Chromium excluent des candidats les éléments dont l’opacité est nulle, parce qu’ils sont invisibles pour l’utilisateur, et un élément ne peut être retenu comme plus grand élément de contenu qu’une fois rendu et visible. La conséquence est plus forte qu’un simple ralentissement. Le chronomètre du LCP ne démarre pas plus tard : il tourne depuis la navigation, mais il ne trouve simplement rien à mesurer tant que le voile n’est pas levé.
Le raisonnement vaut aussi pour visibility: hidden, l’autre règle utilisée par certains éditeurs, dont Optimizely dans son snippet non bloquant. Un élément en visibilité cachée occupe sa place dans la mise en page mais n’est pas peint, et un élément qui n’est pas peint n’est pas visible pour l’utilisateur. Dans les deux cas, le premier candidat au LCP apparaît au moment de la levée du masque, jamais avant. La différence entre les deux propriétés se joue ailleurs, sur les animations et les événements, pas sur la métrique.
Une relation linéaire, sans amortissement
Beaucoup de coûts de performance se recouvrent partiellement : une police lente et une image lente se chargent en parallèle, et retirer l’une ne fait pas gagner tout son temps. Le pré-masquage échappe à cette règle. Il s’applique après tout le reste, sur le seul chemin qui mène à l’affichage, et il s’additionne intégralement au LCP. Si votre image principale est prête à 1,8 seconde et que le masque tombe à 2,1 secondes, le LCP mesuré est 2,1, point. La chronologie ci-dessous superpose les deux scénarios sur une même page.
Une conséquence moins connue mérite d’être relevée. Le navigateur cesse d’émettre de nouveaux candidats au LCP dès que l’utilisateur interagit avec la page, par un tap, un défilement ou une touche, comme l’indique la même page de web.dev. Un visiteur impatient qui fait défiler un écran vide pendant le masquage fige la mesure avant même qu’un candidat n’existe. Selon les outils, cette visite ressort alors sans LCP ou avec une valeur aberrante, ce qui explique une partie des écarts entre votre RUM et les données CrUX.
Le masquage partiel est une fausse bonne idée
Tous les éditeurs proposent de restreindre le masque à un conteneur plutôt qu’au <body> entier. Adobe documente le remplacement de body {opacity: 0 !important} par #container-1, #container-2 {opacity: 0 !important}, et la librairie non bloquante d’Optimizely accepte une liste de sélecteurs. Le gain n’est réel que si l’élément LCP est en dehors du périmètre masqué. Or en e-commerce comme en édition, le visuel testé est précisément l’élément LCP : le hero, la photo produit, le titre principal. Masquer seulement ce bloc revient à masquer exactement ce que la métrique attend.
Un piège de terrain s’ajoute à cette limite. Le snippet fourni par défaut vise parfois un sélecteur qui n’existe pas dans la page, à la suite d’une refonte ou d’un changement de thème. L’équipe se croit protégée du flicker alors que le masquage ne s’applique à rien, et le test tourne avec un biais que personne ne voit. La seule vérification fiable consiste à lire la règle CSS réellement appliquée dans le navigateur, ce que la dernière partie de cet article détaille.
Le second masquage que vous n’avez pas vu
Chez Adobe, deux mécanismes coexistent. Le snippet de pré-masquage du <head>, recommandé quand at.js est chargé en asynchrone, pose un body {opacity: 0 !important} pendant 3 000 ms. Mais la bibliothèque at.js embarque son propre masquage interne, piloté par le réglage bodyHidingEnabled, à true par défaut, qui passe le <body> en opacité nulle dès son exécution et jusqu’à la réponse du serveur Target. Retirer le snippet ne suffit donc pas : le masquage de la bibliothèque doit être désactivé explicitement, et avant son chargement.
<script>
// A placer AVANT le chargement d'at.js
window.targetGlobalSettings = {
  // Masquage interne de la bibliotheque : true par defaut.
  // Le snippet de pre-masquage du head est un second mecanisme, independant.
  bodyHidingEnabled: false,

  // Ou, pour le conserver mais le restreindre au bloc teste :
  // bodyHiddenStyle: '#hero {opacity: 0 !important}'
};
</script>
Le même principe existe chez Wingify, ex-VWO, dont le SmartCode asynchrone masque le <body> par défaut via la variable hide_element, et chez Kameleoon, dont le tag d’installation porte sa propre règle bloquante. Dans chaque cas, le masque appartient à l’outil, pas à votre page, et sa désactivation passe par la configuration de l’outil. Reste à mesurer ce que tout cela coûte sur les trois Core Web Vitals.
Quel est l’effet réel sur les Core Web Vitals ?
Le LCP absorbe l’intégralité de la durée du masque, le CLS absorbe le coût de la solution inverse, et l’INP paie un coût de présence permanent. Sur une page dont l’image principale est prête à 1,8 seconde, un masque de 600 ms suffit à franchir le seuil des 2,5 secondes fixé par Google, et à faire basculer l’URL dans la catégorie à améliorer de la Search Console.
LCP, le plus touché
Le mécanisme a été décrit plus haut, reste l’ordre de grandeur. Kameleoon annonce lever sa règle en moins de 50 ms une fois son script chargé, ce qui est le cas favorable : un fichier de 29 Ko compressé, servi depuis un CDN, sur une bonne connexion. Le cas défavorable est le visiteur mobile sur réseau dégradé, pour qui le téléchargement seul peut dépasser le délai de sécurité, et qui attend alors la totalité du timeout.
Notre guide sur le LCP et comment l’optimiser détaille les quatre sous-parties de la métrique, du TTFB au délai de rendu. Le pré-masquage s’ajoute à la dernière, celle que les optimisations d’images et de serveur ne touchent jamais : on peut avoir une image parfaitement préchargée et un LCP médiocre, simplement parce que le voile tombe tard.
CLS, le coût de la solution inverse
Désactiver le masque déplace le problème sans le résoudre. Sans pré-masquage, la variante remplace le contenu après affichage, et ce remplacement produit un décalage de mise en page dès que la variante n’a pas exactement les dimensions de l’original. La documentation du Cumulative Layout Shift précise un point que presque tout le monde rate : l’exonération hadRecentInput ne couvre que les 500 millisecondes qui suivent un événement discret, tap, clic ou touche, et le défilement n’en fait pas partie. Un décalage produit pendant que le visiteur fait défiler la page compte donc intégralement.
Le cas est fréquent sur mobile, où le visiteur commence à défiler avant la fin du chargement. Un test qui insère un bandeau de réassurance sous le hero, ou qui allonge un bouton, déclenche alors un décalage à la fois visible et comptabilisé. Notre article sur le CLS et comment l’optimiser explique comment réserver l’espace à l’avance ; pour un test A/B, cela signifie concevoir la variante à dimensions égales, ce qui n’est pas toujours compatible avec ce que l’on veut tester.
INP, le coût de présence
Les outils d’A/B testing ne se contentent pas d’attendre. Pour appliquer une variante sur un élément qui n’existe pas encore, ils surveillent le DOM. Adobe expose un réglage selectorsPollingTimeout à 5 000 ms, la durée pendant laquelle at.js interroge la page à la recherche des sélecteurs de l’expérience. Kameleoon décrit un moteur qui capture les événements du DOM en temps réel. Ce travail s’exécute sur le thread principal, et il tombe dans la fenêtre de mesure de l’INP à chaque interaction qui coïncide avec lui.
Notre guide sur l’INP et comment l’optimiser montre pourquoi les observateurs de mutations sont parmi les premiers suspects d’une interaction lente : chaque modification du DOM provoquée par le clic réveille l’observateur, qui réévalue ses sélecteurs avant que le navigateur ne puisse peindre la réponse.
Le point important est que ce coût est payé même sans test actif. Le script se charge, s’initialise, pose ses cookies et son stockage local, met en place sa surveillance, puis constate qu’aucune campagne ne cible cette page. AB Tasty indique d’ailleurs que son tag pèse 35 Ko à vide, avant toute campagne, et considère qu’au-delà de 125 Ko il devient trop lourd pour de bonnes performances. Le coût de présence est continu, indépendant du nombre de tests, y compris des mois après la fin de la dernière campagne.
Ce que votre audit Lighthouse ne montrera pas
Deux angles morts rendent ce sujet difficile à diagnostiquer avec les outils habituels. Le premier tient à la nature de l’INP : c’est une métrique de terrain, qui exige de vraies interactions, et un audit de laboratoire n’en produit pas. Lighthouse s’appuie sur le Total Blocking Time comme approximation, qui capte les tâches longues du chargement mais pas le coût d’un observateur qui se réveille au moment du clic. Le coût de présence est donc invisible dans un rapport PageSpeed, et il faut un RUM pour le voir.
Le second angle mort est plus subtil, et plus utile. Si votre outil répond en 400 ms en temps normal, réduire son timeout de 3 000 à 1 000 ms ne change strictement rien au cas nominal, seulement au 95e et au 99e centile, c’est-à-dire aux visiteurs pour qui l’outil n’a pas répondu à temps. Une mesure en laboratoire, sur une connexion simulée stable, ne montrera aucun gain.
Le gain est pourtant réel en conditions de terrain, sur les visiteurs les plus mal lotis, ceux qui pèsent le plus dans le 75e centile de CrUX. Notre comparatif PageSpeed Insights vs. Lighthouse revient sur cette différence entre données de laboratoire et de terrain : sur ce sujet, seule la donnée de terrain dit la vérité.
Ce que nous trouvons dans les implémentations que nous auditons
La documentation des éditeurs décrit un comportement de référence. Le code qui tourne réellement sur un site en production s’en éloigne souvent, et c’est dans cet écart que se cache l’essentiel du coût. Les constats qui suivent viennent de nos audits de performance sur des sites de secteurs variés ; ils sont anonymisés, mais chacun est reproductible sur votre propre site avec les vérifications données en fin d’article.
Le masquage n’est pas toujours celui qu’on décrit
La littérature parle d’opacity: 0 sur le <body>. Sur un site de services éducatifs, l’outil masquait la page entière par une règle * { visibility: hidden !important; }, appliquée à chaque élément du document et injectée de façon synchrone dans le <head>, assortie d’un délai de sécurité d’une seconde. L’effet relevé portait sur le FCP, le LCP, le Speed Index et l’INP à la fois.
Le principe reste le même, rien n’est peint donc rien n’est candidat, mais l’implémentation varie d’un éditeur à l’autre et d’une version à l’autre. Le sélecteur universel a en outre un coût propre : il s’applique à chaque nœud du document, et sa levée force un recalcul de style sur l’arbre entier. C’est la raison pour laquelle il faut lire le code de son propre site plutôt que de se fier à la documentation.
Un coût permanent pour un usage intermittent
C’est le constat le plus fréquent, et le plus facile à corriger. Sur un site e-commerce de mobilier, l’outil de test était chargé sur l’intégralité du site, très tôt dans la page, et ressortait dans l’audit comme l’un des premiers générateurs de Blocking Time et de tâches longues, alors qu’aucune campagne ne tournait sur la majorité des gabarits. La recommandation formulée est simple : n’activer l’outil que sur les pages et les périodes où un test tourne, et jamais pendant les temps forts commerciaux, où chaque milliseconde de LCP se paie en chiffre d’affaires.
Ce que fait vraiment le script, ligne par ligne
Sur un réseau de sites de comparaison, l’analyse détaillée du script d’un outil du marché a relevé une boucle d’attente active interrogeant toutes les 100 ms un drapeau de chargement de la bibliothèque, soit plusieurs centaines de millisecondes de processeur consommées à ne rien faire. S’y ajoutaient un brassage massif de cookies et de stockage local, un JSON.parse appelé deux fois pour lire un seul champ, et des requêtes de collecte émises via new Image().src. Aucun de ces défauts n’est visible dans la documentation, tous le sont dans l’onglet Performance des DevTools.
Le dernier point mérite explication. Une image demandée par script est traitée par le navigateur comme une ressource ordinaire, avec sa résolution DNS, sa connexion et sa file d’attente, là où navigator.sendBeacon() ou fetch() avec keepalive passent en arrière-plan et survivent à la fermeture de la page. Multipliée par le nombre d’événements collectés, cette technique héritée des années 2000 occupe des connexions dont les ressources critiques ont besoin pendant le chargement.
Un détail du même audit vaut un encadré. Les mécanismes de report déjà en place sur le site étaient rendus inopérants parce que l’appel passait par un tag d’intégration asynchrone propre à l’éditeur. L’équipe avait bien mis en place la solution recommandée, et le mode d’installation conseillé par l’outil l’annulait. L’abandon de l’outil sur ce périmètre a produit un script cinq fois plus léger, la disparition des styles d’anti-flicker, un LCP réduit de plusieurs centaines de millisecondes et un INP amélioré. Ce n’est pas la conclusion à généraliser, c’est l’ordre de grandeur à connaître.
Deux outils pour la même fonction
Sur un site e-commerce de cosmétiques, la pile comportait à la fois un outil d’A/B testing et une plateforme de personnalisation qui proposait déjà l’A/B testing. Les outils d’analyse d’expérience et de test font partie des familles les plus génératrices de Blocking Time, parce qu’ils enregistrent les actions des utilisateurs et interagissent avec le contenu des pages. La recommandation a été de supprimer la redondance pour redresser un INP dégradé sur mobile comme sur desktop, avant même de toucher au reste de la pile.
Pourquoi on ne peut pas simplement le différer
Ce point de doctrine gouverne tout le reste, et il surprend souvent les équipes techniques. Contrairement aux scripts de mesure, qui se reportent après le chargement sans dommage, comme nous l’expliquons à propos de l’impact de Google Analytics, un outil d’A/B testing doit être prioritaire : le différer, c’est garantir le flicker et ruiner la validité du test. Il n’existe donc pas de solution par le report.
Les seuls leviers réels sont la restriction de périmètre, la restriction de durée, le passage côté serveur ou la suppression. Chacun a un coût, et aucun ne se décide sans savoir ce que l’outil en place coûte réellement. Encore faut-il savoir lequel des outils du marché coûte le plus cher, et sur ce point les classements publics induisent en erreur.
Quel outil d’A/B testing est le plus rapide ?
La question est mal posée, et les classements publics y répondent mal. L’indicateur le plus cité, l’impact moyen du projet third-party-web, mesure du temps d’exécution sur le thread principal, de 307 ms pour Monetate à 1 542 ms pour Kameleoon, et ignore le temps d’attente du pré-masquage. Un outil léger au bundle mais agressif au masquage y paraît excellent tout en dégradant fortement le LCP.
Ce que mesurent les classements publics
Le projet third-party-web de Patrick Hulce agrège chaque mois les audits Lighthouse de l’HTTP Archive sur environ quatre millions de sites mobiles, et attribue à chaque tiers le temps d’exécution de ses scripts sur le thread principal. Les outils de test y sont rangés dans la catégorie Analytics, faute d’une catégorie dédiée. Dans le jeu de données consulté le 17 septembre 2026, les cinq éditeurs les plus représentés se classent ainsi, du plus léger au plus lourd, avec le nombre de pages où chacun est détecté :
- Monetate, 307 ms d’impact moyen sur 2 490 pages ;
- VWO, 465 ms sur 10 913 pages ;
- AB Tasty, 524 ms sur 7 116 pages ;
- Optimizely, 898 ms sur 25 015 pages ;
- Kameleoon, 1 542 ms sur 3 585 pages.
Ces chiffres sont exacts et utiles, à condition de savoir ce qu’ils mesurent. Il s’agit du temps passé par le processeur à exécuter les scripts de l’éditeur, tel que l’audit bootup-time de Lighthouse l’attribue, sur un chargement de laboratoire sans interaction. Ils ne disent rien du temps pendant lequel la page est restée masquée, ni de ce que le script fait au moment d’un clic. Ce sont deux coûts différents, et le second n’apparaît dans aucun classement public.
Pourquoi ce classement peut désigner le mauvais gagnant
Imaginez deux outils. Le premier exécute 300 ms de JavaScript mais masque la page 1 200 ms, parce que sa bibliothèque est servie depuis une origine lente et que son délai de sécurité est long. Le second exécute 900 ms de JavaScript mais lève son masque en 200 ms. Le classement place le premier loin devant, et le LCP de vos visiteurs dit exactement l’inverse. Le classement mesure ce que l’outil fait faire au processeur, pas ce qu’il fait attendre au visiteur. Le schéma ci-dessous décompose la barre en ses deux segments.
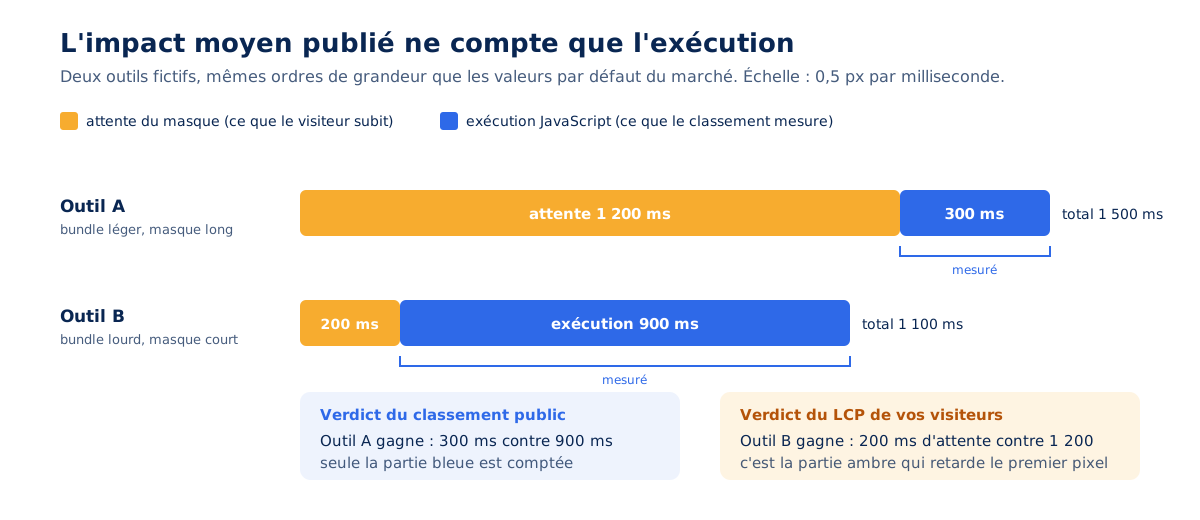
Le consultant britannique Andy Davies, l’un des premiers à avoir mesuré ce mécanisme sur des sites réels avec WebPageTest, en tirait dès 2020 une conclusion qui n’a pas vieilli et qui déplace le débat de l’anti-flicker vers ce qu’il compense.
Fondamentalement, le snippet anti-flicker est le symptôme d’un problème plus large, et ce problème est que les outils de test finissent leur exécution trop tard.
Andy Davies, consultant en web performance, dans son article The Case Against Anti-Flicker Snippets, publié le 16 novembre 2020
Il pointe au passage une aggravation propre à Chrome, documentée par Addy Osmani dans son article sur les priorités de chargement des scripts : un script async placé dans le <head> est déprioritisé et repoussé dans la seconde phase du chargement. Un outil de test chargé en asynchrone commence trop tard avant même de finir trop tard, ce qui explique pourquoi les éditeurs qui recommandent l’asynchrone ont besoin d’un masque si long. Ce n’est pas le classement qu’il faut lire, ce sont les valeurs par défaut.
Les valeurs par défaut, le vrai critère de comparaison
Le tableau suivant compare, pour chaque éditeur, ce que sa documentation officielle déclare au jour de la rédaction : la durée maximale du masque par défaut, le périmètre masqué et la présence d’un second masquage interne à la bibliothèque. C’est le tableau que personne ne publie, et c’est celui qui permet de choisir.
| Éditeur | Délai de sécurité par défaut | Périmètre masqué | Second masquage |
|---|---|---|---|
| Adobe Target | 3 000 ms (snippet de pré-masquage) | body, opacity: 0 | Oui, bodyHidingEnabled dans at.js, actif par défaut |
| Optimizely | 3 000 ms (maskTimeout, snippet non bloquant) | body, visibility: hidden | Non, le snippet nominal est synchrone et bloquant |
| Wingify (ex-VWO) | 2 000 ms puis 2 500 ms (settings_tolerance, library_tolerance) | body via hide_element | Non documenté |
| Kameleoon | 1 000 ms (kameleoonLoadingTimeout) | Page entière, règle CSS bloquante | Non, moteur anti-flicker intégré au script |
| AB Tasty | Aucun masque de page documenté | Aucun par défaut | Non, le coût est dans le poids du tag |
Deux lectures s’imposent. D’abord, les délais par défaut vont du simple au triple, de 1 000 à 3 000 ms, et Wingify cumule en réalité deux attentes successives, celle des réglages puis celle de la bibliothèque, soit jusqu’à 4 500 ms dans le pire cas. Ensuite, Kameleoon documente que son timeout est atteint chez 2 à 3 % des visiteurs en conditions normales : rapporté au 75e centile de CrUX, ce n’est pas négligeable, mais c’est la seule valeur par défaut compatible avec un LCP sous 2,5 secondes sans reconfiguration.
Un point de vocabulaire, enfin, pour ne pas paraître daté. AB Tasty et VWO ont annoncé leur fusion le 20 janvier 2026, sous l’égide du fonds Everstone Capital, et le 16 septembre 2026, la marque unifiée Wingify a été dévoilée. La documentation de VWO a migré vers help.wingify.com, et les variables JavaScript historiques, settings_tolerance et hide_element, y restent documentées à l’identique. Les deux produits coexistent encore techniquement, avec deux tags et deux comportements d’anti-flicker distincts.
Votre site est-il aussi rapide que vos visiteurs l’espèrent ?
Comment réduire le coût sans casser ses tests ?
Rarement en désactivant l’anti-flicker, et jamais sans mesurer ce qu’on échange. Sans pré-masquage, le coût quitte le LCP pour le CLS, puisque la variante remplace le contenu après affichage, et la validité du test se dégrade. Les trois leviers qui fonctionnent sont le périmètre, le délai et le nettoyage, et Optimizely lui-même rappelle que le flicker ne concerne que les tests visuels au-dessus de la ligne de flottaison.
Restreindre le périmètre plutôt que le supprimer
Le critère de décision est formulé par un éditeur, et il est net. Optimizely écrit dans sa documentation que le flicker n’est un problème que pour les expériences visuelles visibles au chargement, et cite explicitement les tests sous la ligne de flottaison, ceux déclenchés par une action du visiteur, et les déploiements de tunnel à des fins de mesure comme des cas où le masquage n’a aucune raison d’être. Un test de prix, de libellé de bouton en bas de page ou de logique de panier n’a donc pas besoin d’un voile sur le document entier.
La règle opérationnelle en découle. Masquer le périmètre testé, jamais le document, et ne masquer le document que pour les tests de hero, en acceptant alors leur coût sur le LCP pendant la durée du test seulement. Un test de hero qui dure trois semaines coûte trois semaines de LCP dégradé ; un masque global laissé en place toute l’année coûte toute l’année pour des tests qui n’en ont pas besoin.
Régler le délai pour ce qu’il est, un filet
Le timeout ne s’applique pas au cas nominal, il ne s’applique qu’aux visites où l’outil n’a pas répondu à temps. Le réduire améliore la queue de distribution, pas la médiane. La méthode consiste à relever dans son RUM le temps réel de levée du masque au 95e centile, puis à caler le délai légèrement au-dessus : un outil qui répond en 400 ms au 95e centile justifie un filet à 600 ou 800 ms, pas à 3 000.
Le bloc suivant regroupe les clés de configuration réelles de chaque éditeur, telles qu’elles apparaissent dans leur documentation, pour que vous puissiez les chercher dans votre propre code.
/* Optimizely, snippet non bloquant (librairie officielle) */
var maskTimeout = 3000;            // defaut : 3000 ms

/* Wingify, ex-VWO, SmartCode asynchrone */
settings_tolerance = 2000,         // attente des reglages
library_tolerance  = 2500,         // attente de la bibliotheque
hide_element       = 'body';       // '' pour ne rien masquer

/* Adobe Target */
// snippet de pre-masquage du head : dernier argument = 3000 ms
window.targetGlobalSettings = {
  bodyHidingEnabled: true,         // masquage interne d'at.js
  bodyHiddenStyle: 'body {opacity: 0 !important}'
};

/* Kameleoon, tag d'installation */
var kameleoonLoadingTimeout = 1000; // defaut : 1000 ms
Le piège du consentement
Une situation très fréquente et rarement diagnostiquée mérite un schéma. Le snippet de pré-masquage s’exécute inconditionnellement, puisqu’il est inline dans le <head>, mais le chargement de l’outil lui-même est conditionné au consentement, via le tag manager ou la CMP. Pour tout visiteur qui refuse, ou qui tarde à répondre, aucune décision n’arrive jamais et la page reste masquée jusqu’à l’expiration du délai de sécurité : jusqu’à trois secondes d’écran blanc pour une fonctionnalité qui ne s’exécutera pas. Notre guide pour bien choisir sa CMP détaille l’articulation entre consentement et chargement des tiers.
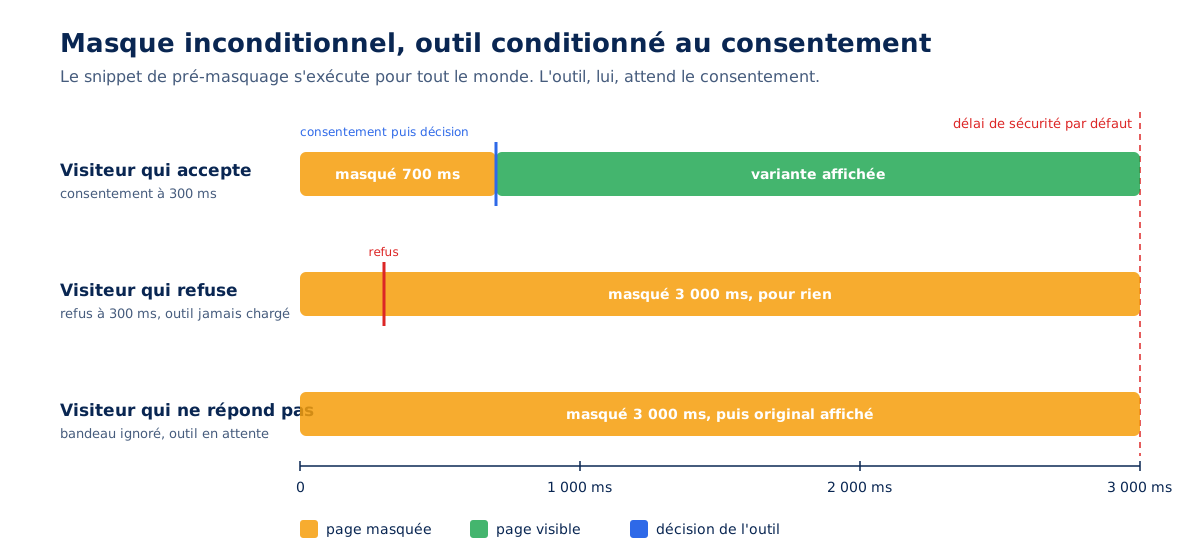
La correction tient en une ligne : conditionner la pose du masque au même signal que le chargement de l’outil, ou lever le masque dès que le refus est connu. Sur un site français où le taux de refus dépasse couramment 30 %, c’est un tiers des visites qui payent le prix maximal d’un outil qui ne tourne pas pour elles.
Nettoyer ce qui ne sert plus
Deux gestes, dont le second est contre-intuitif. Le premier consiste à retirer les campagnes terminées, ce qu’AB Tasty recommande explicitement en rappelant que les vieilles campagnes s’additionnent au poids des campagnes courantes. Le second concerne Optimizely, dont la documentation précise qu’archiver des expériences ne réduit pas le poids du snippet, parce que ce sont les pages et les événements déclarés qui le gonflent, pas les expériences inactives ; chaque expérience y est par ailleurs plafonnée à 1 048 572 octets, soit un peu plus d’un mégaoctet, ce qui donne une idée de ce qu’un projet mal tenu peut faire télécharger.
Un cas d’école, le test qui compte des visiteurs fantômes
Avec les Speculation Rules, une page préparée en arrière-plan est réellement chargée et son JavaScript réellement exécuté, comme l’explique la documentation Chrome du prerendering, qui précise que Google Analytics retarde par défaut sa mesure jusqu’à l’activation, mais que tous les fournisseurs ne le font pas. Un outil d’A/B testing qui ne teste pas document.prerendering enregistre alors une exposition pour un visiteur qui n’a jamais vu la page.
Ce n’est plus seulement la performance qui est en jeu, c’est la validité même du test : des visiteurs comptés dans un groupe sans avoir été exposés diluent l’effet mesuré, et le test conclut à tort qu’une variante ne change rien. Notre article sur les Speculation Rules et le prerendering détaille les effets de bord de cette technique, et celui-ci en est un de plus. Face à tous ces contournements, une question revient dans chaque comité de pilotage : pourquoi ne pas tout passer côté serveur ?
Le test côté serveur est-il la solution ?
Techniquement, oui : un test côté serveur envoie directement le HTML de la variante, donc plus de pré-masquage ni de substitution après affichage, ni coût LCP ni coût CLS. Le prix est organisationnel : un déploiement par variante, une dépendance à l’équipe technique pour chaque test, et la perte de l’autonomie qui a fait le succès des outils client-side depuis 2013. C’est un arbitrage d’organisation autant que de performance.
Ce que le server-side supprime réellement
Quand la décision est prise avant l’envoi de la réponse, le navigateur reçoit une page déjà cohérente. Il n’y a rien à masquer, rien à remplacer, et le script de test se réduit à une collecte d’événements que l’on peut différer sans dommage. Adobe propose un mode hybride, serverState, dans lequel at.js applique les offres récupérées côté serveur sans aucun appel réseau et ne pré-masque que les éléments concernés. C’est la bonne réponse, et il faut le dire clairement : tout ce que l’anti-flicker coûte disparaît quand la variante est décidée en amont.
Ce qu’il coûte en échange
Le server-side déplace le test du navigateur vers le code de l’application. Chaque variante devient une fonctionnalité à développer, à recetter et à déployer, avec le cycle de release qui va avec. L’équipe CRO perd l’éditeur visuel et la capacité de lancer un test dans la journée sans ticket. Sur un site à fort trafic, où un test de hero coûte plusieurs centaines de millisecondes de LCP à des millions de visites, le calcul penche vite vers le serveur. Sur un site plus modeste, la vélocité des tests vaut souvent le coût de performance, à condition de le connaître.
L’edge n’est pas une solution intermédiaire magique
Les offres d’expérimentation en périphérie, sur les workers des CDN, promettent le meilleur des deux mondes : la décision prise avant le navigateur, sans toucher au code applicatif. Cela fonctionne pour les redirections et les substitutions simples de HTML, et c’est un vrai progrès pour ces cas-là.
Pour tout ce qui exige de connaître l’état du visiteur côté client, ou de modifier un composant rendu en JavaScript, les décisions qui ne peuvent pas être prises en périphérie sont regroupées et injectées dans le <head> pour être exécutées par le navigateur. On retombe alors sur le modèle client-side, avec ses coûts, pour une partie des tests. L’edge réduit le périmètre du problème, il ne le supprime pas, et il reste à savoir quoi faire lundi matin.
Que faire concrètement sur son propre site ?
Mesurer d’abord, arbitrer ensuite sur trois décisions : quel périmètre masquer, pendant combien de temps, pour quels tests. La méthode de mesure est celle de n’importe quel tiers, bloquer le domaine de l’outil, recharger, relever l’écart de LCP et de TBT. Lighthouse le permet en ligne de commande, à condition de mesurer une page qui porte effectivement un test actif, sans quoi l’écart ne reflète que le coût de présence.
# Mesure de reference, outil actif
lighthouse https://www.exemple.fr/ --preset=desktop --output=json --output-path=./avec.json

# Meme page, domaine de l'outil bloque (adapter le motif a votre editeur)
lighthouse https://www.exemple.fr/ --preset=desktop --output=json --output-path=./sans.json \
  --blocked-url-patterns="*cdn.optimizely.com*" "*dev.visualwebsiteoptimizer.com*" "*tt.omtrdc.net*"

# Ecart LCP et TBT entre les deux rapports
jq '.audits["largest-contentful-paint"].numericValue, .audits["total-blocking-time"].numericValue' avec.json sans.json
Le chiffre obtenu transforme un débat d’opinion entre l’équipe CRO et l’équipe technique en arbitrage documenté. Il reste incomplet, puisqu’un audit de laboratoire ne voit ni l’INP ni la queue de distribution du timeout, et c’est pourquoi la seconde vérification se fait dans le navigateur, sur le site réel. Le bloc ci-dessous, à placer en tout premier dans le <head> avant le snippet de l’outil, mesure la durée effective du masque et la dépose dans la Performance Timeline, où votre RUM peut la collecter :
<script>
// 1. Duree reelle du masque, mesuree dans le navigateur
performance.mark('mask-start');
new MutationObserver(function (m, obs) {
  var b = document.body;
  if (!b) { return; }
  var cs = getComputedStyle(b);
  if (cs.opacity !== '0' && cs.visibility !== 'hidden') {
    performance.mark('mask-end');
    performance.measure('anti-flicker', 'mask-start', 'mask-end');
    obs.disconnect();
  }
}).observe(document.documentElement, { childList: true, subtree: true, attributes: true });
</script>

// 2. Dans la console, une fois la page chargee : la regle de masquage et son origine
[...document.styleSheets].forEach(function (s) {
  try {
    [...s.cssRules].forEach(function (r) {
      if (/opacity\s*:\s*0|visibility\s*:\s*hidden/.test(r.cssText)) {
        console.log(r.cssText, '<-', s.ownerNode && s.ownerNode.id || s.href || 'inline');
      }
    });
  } catch (e) {}
});

// 3. Dans la console : les requetes de collecte emises par new Image()
performance.getEntriesByType('resource')
  .filter(function (e) { return e.initiatorType === 'img' && /collect|track|event|log/.test(e.name); })
  .forEach(function (e) { console.log(e.name, Math.round(e.duration) + ' ms'); });
La première mesure dit combien de temps vos visiteurs regardent un écran vide, et c’est le seul chiffre qui permette de caler le délai de sécurité. La deuxième affiche la règle CSS réellement en vigueur et son origine, ce qui règle en une ligne la question du sélecteur fantôme et du second masquage. La troisième repère les requêtes de collecte émises comme des images, qui se distinguent par leur initiatorType.
Pour repérer une boucle d’attente active, l’onglet Performance des DevTools suffit : une tâche identique qui revient à intervalle fixe, toutes les 100 ms, est une signature qui ne trompe pas.
Ce que ces mesures ne trancheront pas, c’est la décision finale, et elle mérite d’être posée sans réquisitoire. Un test qui fait gagner deux points de conversion peut parfaitement justifier trois cents millisecondes de LCP pendant trois semaines ; notre article sur le coût d’un site rapide rappelle que la performance est un arbitrage économique, pas une fin en soi.
Ce qui ne se justifie jamais, c’est de payer ce prix sans le savoir, de le payer pour des campagnes terminées, ou de le faire payer aux visiteurs qui ont refusé le consentement. Entre le CRO qui défend sa vélocité et le développeur qui défend son LCP, le chiffre mesuré est le seul arbitre qui ne prenne parti pour personne.
Instrumenter ce coût, le rapporter au gain de conversion et décider en connaissance de cause, c’est précisément ce que produit un audit de performance web ; reconfigurer l’outil, le restreindre ou le remplacer relève ensuite d’une optimisation de performance menée avec l’équipe CRO plutôt que contre elle. La question n’est plus anti-flicker oui ou non, et elle ne l’a jamais été.